【Agent-Native Web】SEO 時代結束了,你的網站 Agent Ready 了嗎?
Cloudflare 推出 isitagentready.com,為網站的「AI Agent 準備程度」制定了第一套標準化度量衡。本文分享筆者的個人網站從 33 分修到滿分 100 的過程,並剖析為什麼「讓 Agent 讀得懂你的網站」正成為比傳統 SEO 更重要的生存問題。
2009 年,Ethan Marcotte 提出了 Responsive Web Design,整個產業花了五年才把「行動優先(Mobile First)」從口號變成標準。2026 年,我們正在經歷同等規模的典範移轉,只不過這次服務的對象不是縮小的螢幕,而是根本沒有螢幕的 AI Agent。
Cloudflare 在 2026 年 Agents Week 推出了 isitagentready.com,一個看似簡單的檢測工具 —— 輸入網址,它告訴你這個網站對 AI Agent 有多友善。
我的個人網站 www.charles-hsiao.com 在第一次掃描時拿了 33 分,被評為 Level 2「Bot-Aware」。修復後達到 100 分,Level 5「Agent-Native」。這篇文章分享整個修復過程,更重要的是 —— 為什麼這件事值得你認真對待。
33 分的真相:你的網站對 Agent 來說是一座迷宮
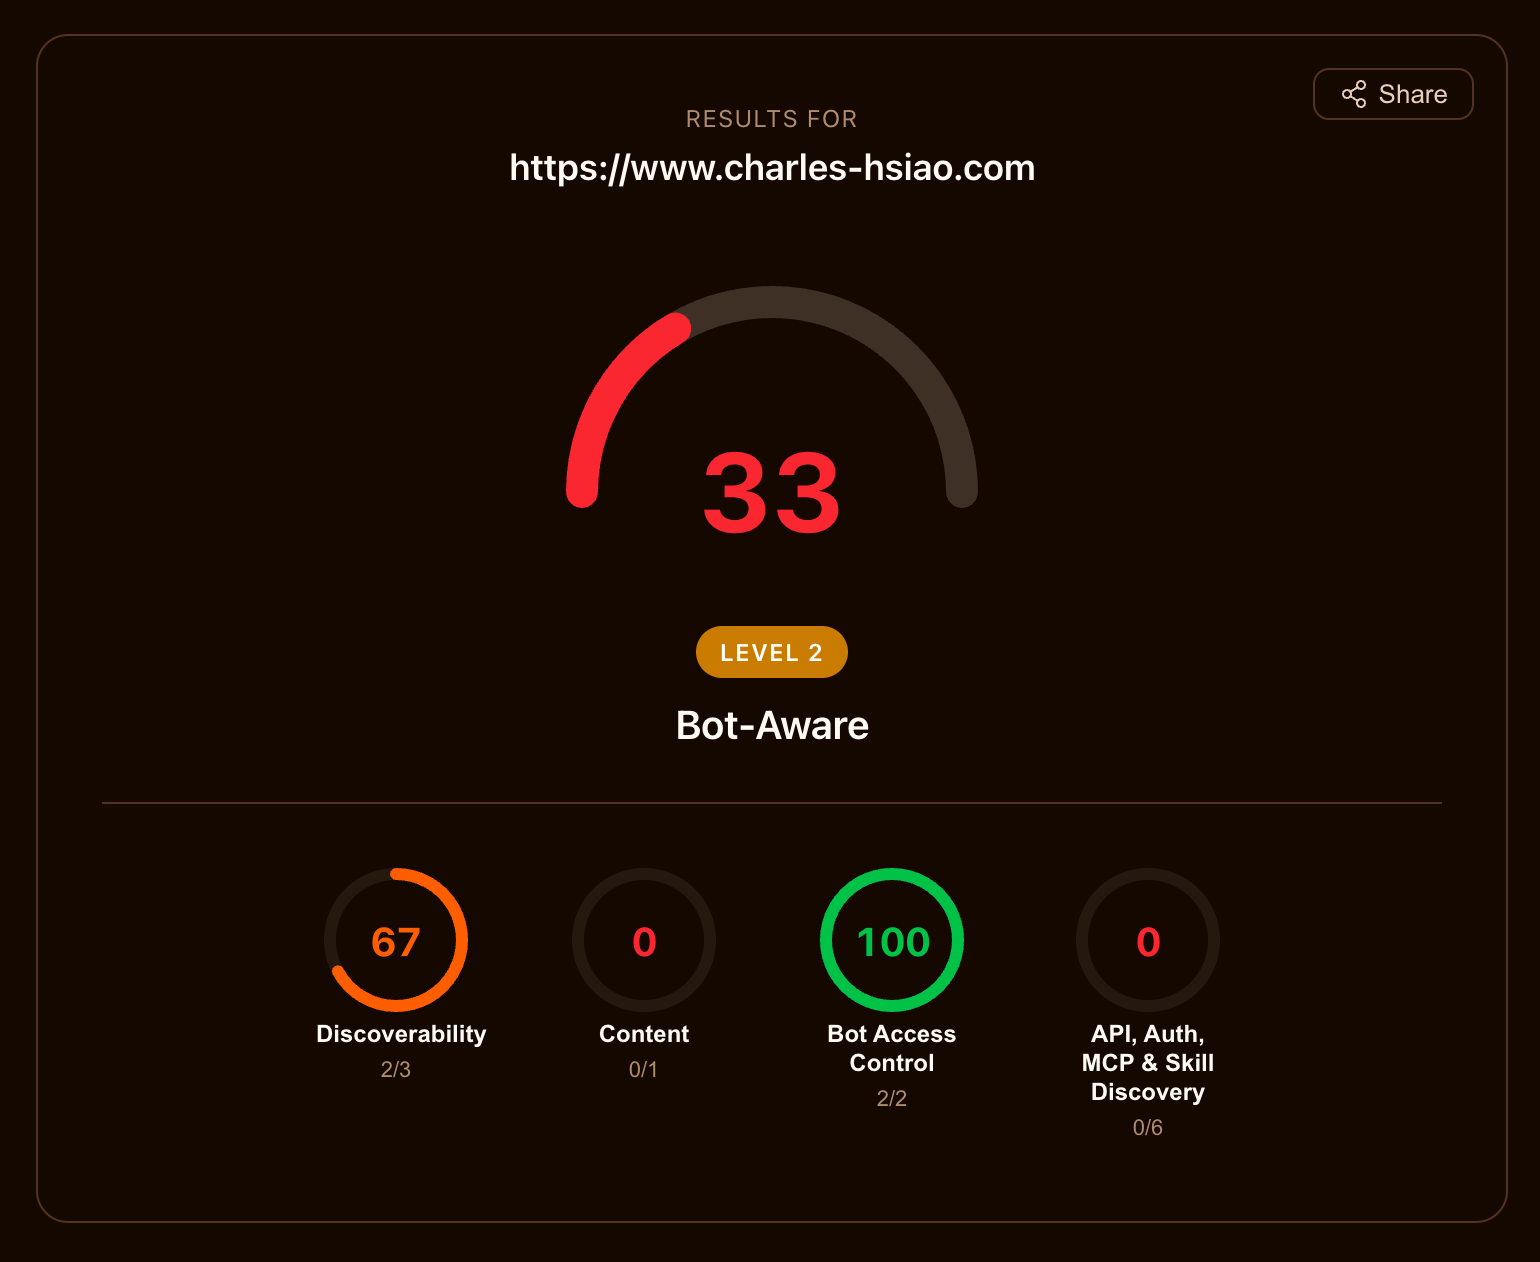
第一次掃描的結果相當殘忍。四大評分維度中,只有 Bot Access Control 拿到滿分(因為 robots.txt 設了 Allow: /),其餘三項全數失守,其中兩項直接掛零:
| 維度 | 分數 | 通過項目 |
|---|---|---|
| Discoverability(可發現性) | 67 | 2/3 |
| Content(內容) | 0 | 0/1 |
| Bot Access Control(存取控制) | 100 | 2/2 |
| API, Auth, MCP & Skill Discovery | 0 | 0/6 |
翻譯成白話:Agent 知道它被允許進入我的網站,但進去之後完全不知道該看什麼、怎麼看、能做什麼。就像你邀請了一位客人進門,卻把燈全關了、菜單藏在閣樓、連座位都沒準備。
isitagentready.com 對全球網站的平均分數據顯示,絕大多數網站仍停留在「為人眼設計」的架構中。問題是,2026 年來敲你家門的,越來越多不是人。
五大維度拆解:Agent 到底需要什麼
在動手修復之前,先理解 isitagentready.com 的評分框架。它將「Agent 準備程度」劃分為五大維度,十六項檢測指標,共同構成一個完整的 Machine-First 交互框架:
| 維度 | 核心檢測項 | 技術標準 | 對 Agent 的意義 |
|---|---|---|---|
| Discoverability | robots.txt, sitemap.xml, Link Headers | RFC 8288, RFC 9309 | 建立資源地圖,減少 Agent 盲目爬網的計算損耗 |
| Content | Markdown Content Negotiation | Accept: text/markdown | 將冗餘 HTML 轉為高資訊密度 Markdown,節省 80%+ Token |
| Bot Access Control | AI Bot Rules, Web Bot Auth | RFC 9309, JWKS | 透過加密簽章建立機器間信任 |
| Capabilities | API Catalog, MCP Server Card, Agent Skills | RFC 9727, SEP-1649 | 讓 Agent 知道網站能「做什麼」,而非只能「讀什麼」 |
| Commerce | x402 Protocol, UCP, ACP | HTTP 402, UCP | Agent 自主支付與結帳的基礎設施 |
Discoverability:讓 Agent 在毫秒內找到路
robots.txt 與 Sitemap
這是最基本的。robots.txt 設定 Allow: / 對所有 Bot 開放,Sitemap 指向 sitemap index。但 isitagentready.com 的檢查已不僅限於傳統的 Allow / Disallow 指令,而是側重於是否符合 RFC 9309 標準,並包含為 AI Agent 特別設定的規則。
Link Headers(RFC 8288):頭部優先的發現機制
這是最被低估的一項。與埋藏在 HTML <a> 標籤中的超連結不同,HTTP Response Header 中的 Link Header 允許 Agent 在不解析整個 DOM Tree 的情況下,直接獲取與當前資源相關的 API 目錄、RSS Feed 或 Sitemap。
在 Cloudflare Pages 的 _headers 檔案中,為首頁加上一行:
/
  Link: </.well-known/api-catalog>; rel="api-catalog", </rss.xml>; rel="alternate"; type="application/rss+xml", </sitemap-index.xml>; rel="describedby"; type="application/xml"
對人類來說,這行設定毫無視覺差異。但對 Agent 而言,它等於在門口貼了一張清晰的導覽圖 —— 不需要解析任何 HTML 就能知道網站有什麼資源可以取用。
Content:從視覺冗餘到語義密度
這是從 0 分到滿分跨度最大的一項。
問題:HTML 對 Agent 來說是噪音
當前的網際網路是為視覺呈現而設計的。一個典型的部落格頁面,HTML 中超過 70% 的標記是為了字體、顏色、佈局、響應式斷點而存在的。對以 LLM 為核心的 AI Agent 來說,這些全是無效噪聲 —— 消耗昂貴的 Context Window,增加 Token(權杖)費用,卻不帶來任何資訊增益。
解法:Markdown Content Negotiation
isitagentready.com 檢測的核心是 Markdown Content Negotiation —— 利用 HTTP 協議原生的 Accept Header,當 Agent 發送 Accept: text/markdown 時,伺服器應直接返回 Markdown 版本。
根據 Cloudflare 的研究數據,Markdown 內容體積通常比 HTML 小 80%,意味著 Agent 以五分之一的成本獲得同等資訊,且 LLM 對結構化 Markdown 的理解準確度顯著高於雜亂的 HTML。
實作方式是在 Cloudflare Worker 中攔截帶有 Accept: text/markdown 的請求,取得靜態 HTML 後即時轉換為 Markdown 再回應。核心邏輯:
const accept = request.headers.get('Accept') ?? '';
const wantsMarkdown = accept
  .split(',')
  .map((t) => t.split(';')[0].trim())
  .includes('text/markdown');

if (wantsMarkdown && assetResponse.ok &&
    (assetResponse.headers.get('Content-Type') ?? '').includes('text/html')) {
  const html = await assetResponse.text();
  const markdown = htmlToMarkdown(html);
  const tokenCount = estimateTokens(markdown);

  return new Response(markdown, {
    status: 200,
    headers: {
      'Content-Type': 'text/markdown; charset=utf-8',
      'x-markdown-tokens': String(tokenCount),
      'Vary': 'Accept',
      'Content-Signal': 'ai-train=yes, search=yes, ai-input=yes',
    },
  });
}
幾個關鍵設計決策:
x-markdown-tokensHeader:讓 Agent 在下載完整內容前就能預知 Token 長度,決定是否需要分塊處理。這個 Header 是 Cloudflare 推廣的標準Content-SignalHeader:明確告訴 Agent 這份內容允許用於 AI 訓練、搜尋索引與 AI 輸入Vary: Accept:確保 CDN 快取能正確區分 HTML 與 Markdown 回應,不會把 Markdown 回給瀏覽器run_worker_first: true:在wrangler.toml中設定,確保每個請求都先經過 Worker 處理,而非直接回傳靜態資源
Cloudflare 也提供了 Markdown for Agents 的一鍵開啟功能,不需要自己寫 Worker,直接在後台啟用即可。自己實作的好處是能完整控制轉換邏輯,以及在 Worker 中同步處理其他 Agent 相關的 Header。
Bot Access Control:從 IP 封鎖到加密身份
在 Agent-Native Web 中,傳統的 Bot 防護面臨悖論:網站既要防範惡意爬蟲,又要開放入口給代表用戶的合法 Agent。isitagentready.com 強調了從 IP 範圍過濾轉向「加密認證」的必要性。
Web Bot Auth 是這個領域的核心提案。它要求 AI Agent 在 HTTP 請求中附加加密簽章,並在網站的 /.well-known/http-message-signatures-directory 發布公鑰(JWKS)進行驗證。這確保了訪問請求確實來自聲稱的實體(如 OpenAI 或 Anthropic),且請求未被篡改。
robots.txt 設定 Allow: / 可通過基本的 Bot Access Control 檢查。更完整的 Web Bot Auth 實作適合有付費內容或敏感 API 的網站 —— 屆時加密認證從「可選」變成「必要」。
Capabilities:將網站從資訊源變成工具箱
這是 Agent 準備度最具前瞻性的維度。Agent 與網站的互動正從「閱讀內容」演進為「調用功能」,而以下三個標準正是這場轉變的基石。
API Catalog(RFC 9727):API 版的 robots.txt
在 /.well-known/api-catalog 發布一份 linkset+json 文件,讓 Agent 自動發現網站所有的 OpenAPI 規格、文件與健康檢查端點:
{
  "linkset": [{
    "anchor": "https://www.charles-hsiao.com/api/views/",
    "service-desc": [{ "href": "https://www.charles-hsiao.com/api/views/openapi.json", "type": "application/json" }],
    "status": [{ "href": "https://www.charles-hsiao.com/api/views/health", "type": "application/json" }],
    "auth": [{ "href": "https://www.charles-hsiao.com/.well-known/oauth-authorization-server", "type": "application/json" }]
  }]
}
這消除了 Agent 需要手動爬「開發者門戶」頁面的需求。一個 HTTP GET 請求,就能取得完整的 API 地圖。
MCP Server Card(SEP-1649):讓 Agent 像調用函數一樣調用網站
Model Context Protocol(MCP)是當前 AI 基礎設施中最受關注的標準之一。在 /.well-known/mcp/server-card.json 發布 MCP Server Card,描述網站提供的遠端資源與認證流程:
{
  "$schema": "https://static.modelcontextprotocol.io/schemas/v1/server-card.schema.json",
  "name": "com.charles-hsiao/homepage",
  "title": "Charles Hsiao's Homepage & Blog",
  "capabilities": { "resources": true, "tools": false, "prompts": false },
  "transport": { "type": "streamable-http", "endpoint": "https://www.charles-hsiao.com/mcp" }
}
對個人部落格來說,宣告 resources: true 已足夠。但這個框架的威力在於可擴展性 —— 電商網站若宣告 tools: true,Agent 就能直接調用「查庫存」、「加入購物車」等功能,如同調用本地函數。
Agent Skills Index:教 Agent 新技能
Cloudflare 提出的 /.well-known/agent-skills/index.json 規範,為 Agent 提供了針對特定域名的指令或腳本。可以為網站定義多個 Skill,我在這個網站加入了:
| Skill | 用途 |
|---|---|
markdown-negotiation | 教 Agent 如何透過 Content Negotiation 取得 Markdown 版本 |
content-retrieval | 教 Agent 如何搜尋與取得部落格文章 |
author-identity | 提供作者的專業背景與聯絡方式 |
每個 Skill 都是一份獨立的 Markdown 文件。當 Agent 掃描到這個索引,它就能自動學會如何與這個網站互動 —— 不需要人類手動配置。
OAuth Metadata:為未來的機器間認證做準備
isitagentready.com 還檢測了 OAuth 2.0 的 Authorization Server Metadata(/.well-known/oauth-authorization-server)與 Protected Resource Metadata(/.well-known/oauth-protected-resource)。
即使網站目前沒有需要認證的 API,也建議發布這兩份 metadata 文件,明確宣告「不需要認證」。對 Agent 來說,「明確知道不需要認證」和「不知道需不需要認證」是截然不同的狀態 —— 前者讓 Agent 直接行動,後者讓 Agent 陷入不確定性,甚至放棄這個網站轉向其他來源。
修復結果:從 Bot-Aware 到 Agent-Native
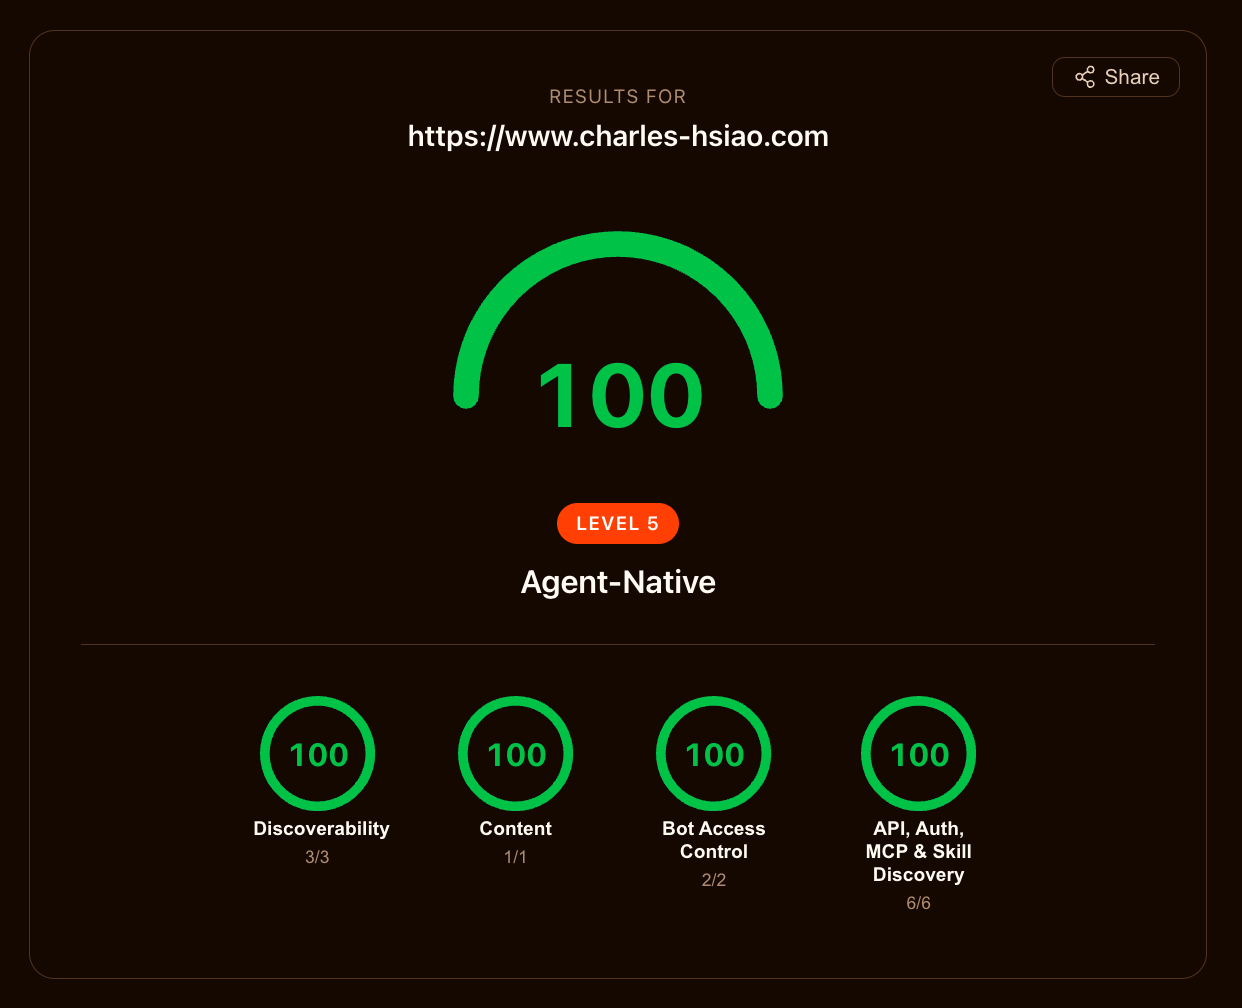
所有修復完成後,重新掃描的結果:
| 維度 | 修復前 | 修復後 |
|---|---|---|
| Discoverability | 67 (2/3) | 100 (3/3) |
| Content | 0 (0/1) | 100 (1/1) |
| Bot Access Control | 100 (2/2) | 100 (2/2) |
| API, Auth, MCP & Skill Discovery | 0 (0/6) | 100 (6/6) |
| Overall | 33 — Level 2 Bot-Aware | 100 — Level 5 Agent-Native |
整個修復涉及的檔案不超過十個,沒有改動任何前端 UI 程式碼,對人類使用者的體驗零影響。但對 Agent 來說,這個網站從一座漆黑的迷宮,變成了一棟燈火通明、附有說明書、還有專人接待的建築。
身為在華人文化長大的小孩,只有 100 分才能回家見父母。99 分?「差一分,差哪裡?」
為什麼你該在意:AI 正在重寫流量規則
修復分數只是手段,更值得思考的是背後的 Why。
過去二十年,Google 搜尋引擎主宰了網際網路的流量分配。網站透過 SEO(Search Engine Optimization,搜尋引擎最佳化)爭奪關鍵字排名,用戶點擊連結進入頁面。但隨著 AI Overviews 和自主 Agent 的普及,用戶獲取資訊的行為正從「點擊連結進入頁面」轉向「在 AI 介面中獲取綜合回答」。
這個轉變催生了一個新的優化維度:AEO(Answer Engine Optimization,答案引擎最佳化)。
SEO 的目標是「在搜尋結果中出現」;AEO 的目標是「成為 AI 在回答問題時直接引述的來源」。兩者的底層邏輯截然不同。SEO 競爭的是關鍵字密度與外部連結數量,AEO 競爭的是語義清晰度與機器可讀性 —— 內容結構是否足夠明確,讓 LLM 在生成回答時能精確擷取並引用。
Agent-Native Web 的建設,正是 AEO 的基礎設施層。Markdown Content Negotiation 降低了 AI 解析你的內容的成本;MCP Server Card 讓 Agent 知道如何「使用」你的服務;API Catalog 讓 Agent 能直接調用你的能力,而非只是讀取你的頁面。這些不是可選的加分項,而是在 AEO 競爭中的入場門票。
對商業網站來說,AEO 的戰場還延伸到了交易層。當 Agent 不只是「讀取資訊」,而是開始代替用戶「執行購買」時,網站是否支援機器可直接結帳的支付協議,將決定它能否出現在 Agent 的採購清單上。x402 協議正是為此而生 —— 它讓 Agent 在遇到付費資源時,能透過一個標準化的 HTTP 流程自主完成小額支付,無需人類介入。對電商、SaaS、訂閱制內容平台而言,x402 的重要性不亞於 MCP:前者讓 Agent 讀得懂你,後者讓 Agent 買得了你。
延伸閱讀:【Agentic Payment 系列 #1】HTTP 402 沉睡三十年後醒來:x402 如何讓支付成為網際網路的一等公民
如果你的網站無法被 Agent 高效、準確地讀取,它將面臨「算法隱形」的風險。當 Agent 無法解析你的內容或調用你的 API 時,它會轉而引述其他更具機器可讀性的競爭對手。SEO 時代,你的對手只需要比你排名更高;AEO 時代,你的對手只需要比你更容易被 AI 讀懂。
Cloudflare 的棋局:成為 Agent 時代的基礎設施
最後一個問題:Cloudflare 為什麼要免費提供這個工具?
isitagentready.com 本質上是一個需求產生器:先告訴你「你的網站還沒準備好」,再提供「一鍵升級」的解決方案。它推廣的 Markdown Content Negotiation 由 Cloudflare 的邊緣節點即時完成 —— 網站擁有者不需要改一行源站程式碼,只要開啟 Workers 服務就能升級。標準的制定者同時也是最佳解法的提供者,這是優秀的產品策略,不是巧合。
更深層來看,Cloudflare 正在從「DDoS 防禦者」轉型為 Agent 時代的「意圖識別者」。isitagentready.com 檢測的 Web Bot Auth 與其 Verified Bots Directory 深度整合,願景是建立一個全球性的機器身份基礎設施 —— 成為 AI Agent 與網際網路之間的通用轉接頭。
給工程師的行動清單
不知道從何下手?不用擔心 —— isitagentready.com 在每一個沒通過的檢查項目下方,都直接附上了修復用的 Prompt 與 Agent Skill 檔案。
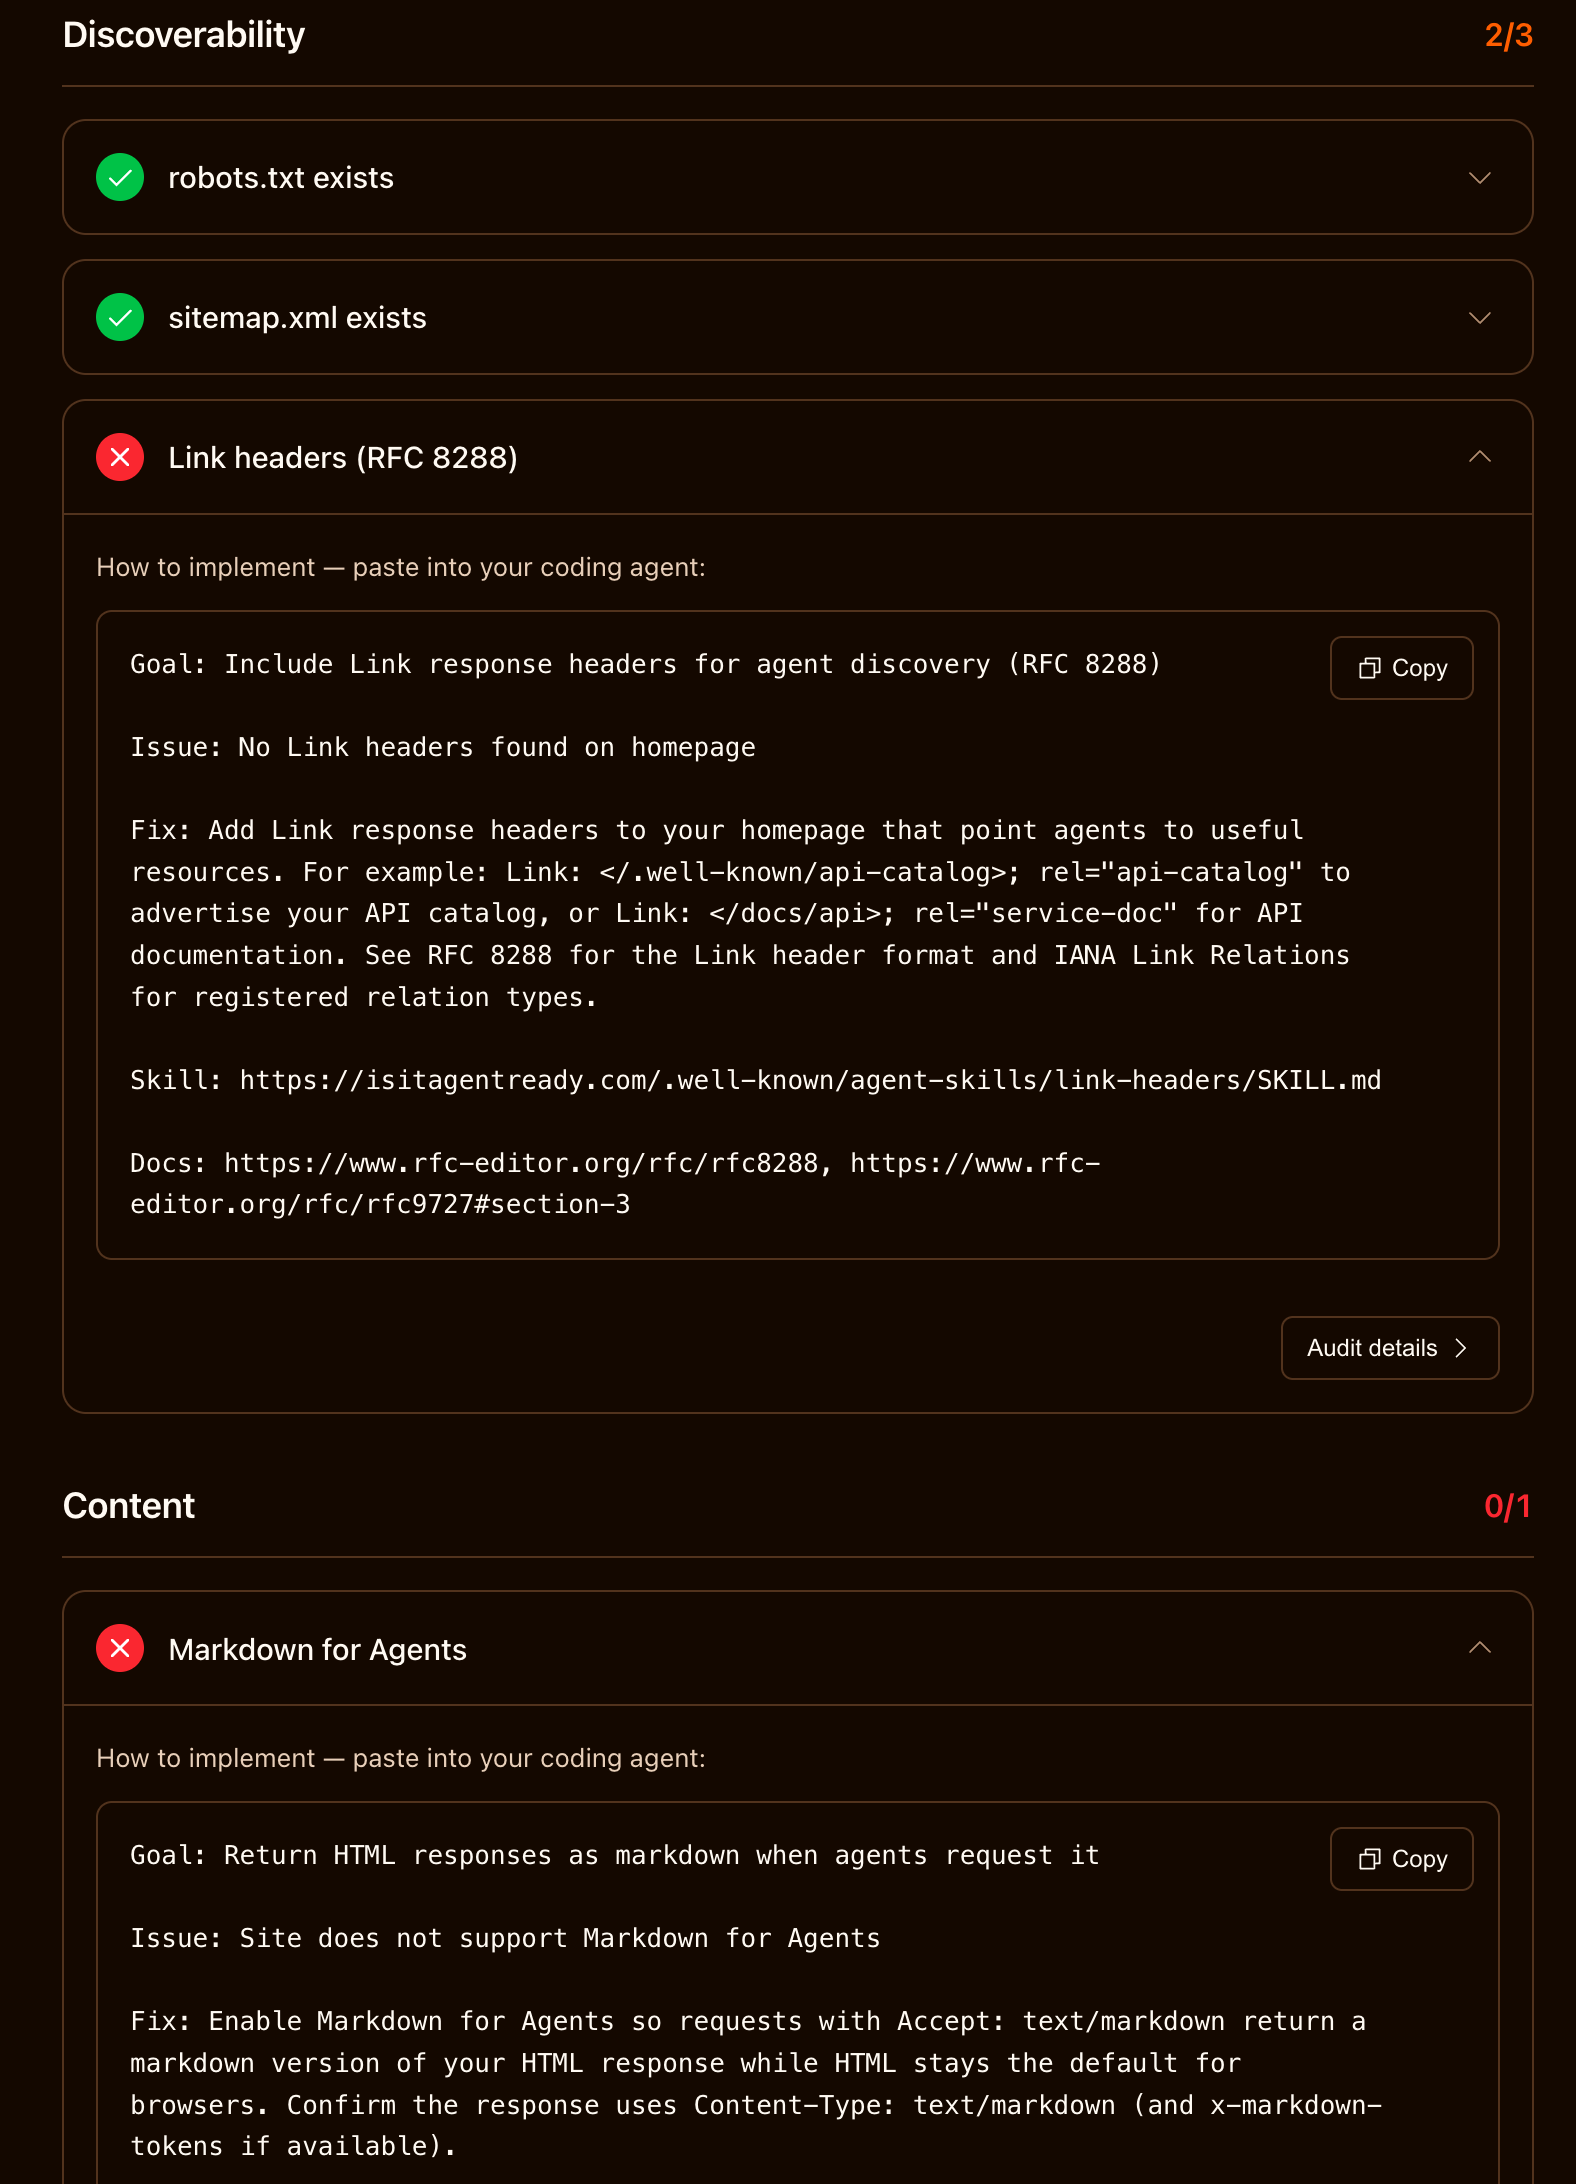
你要做的只是把那段 Prompt 貼給你慣用的 Coding Agent(Cursor、GitHub Copilot、Claude Code,任何一個都行),泡杯咖啡,Agent 就幫你改好了。
更重要的行動是:買入 Cloudflare(NET)股票。
附註:llms.txt
isitagentready.com 的評分框架目前尚未涵蓋,但同樣值得加上的是 llms.txt。概念類似 robots.txt,它是一份放在網站根目錄的純文字檔,用 Markdown 格式說明「這個網站是什麼、有哪些內容、哪些連結最值得 LLM 參考」。當 LLM 需要在 Context Window 有限的情況下快速理解一個網站,/llms.txt 就是它第一個應該讀的檔案。這個網站已有部署(/llms.txt),感興趣的讀者可以直接參考 llmstxt.org 的規範。
結語
isitagentready.com 這套工具揭示的是網際網路交互邏輯的底層變革 —— 未來的網路競爭力不再取決於誰的視覺設計更精美,而取決於誰的基礎設施對機器更透明、更具功能性。
過去十五年,我們把網頁從桌面適配到手機。下一個十五年,我們要把網頁從人類適配到 Agent。差別在於,Agent 不會抱怨你的字太小,但會直接跳過它讀不懂的網站。
當你的競爭對手已經用標準化的語義介面在 Agent 的世界裡被找到、被引述、被調用時,你的 HTML 再精美,也只是一座 Agent 看不見的美術館。