【AIOps】Doc2Vec:用向量資料庫打造組織的儲思盆
介紹 kagent-dev/doc2vec —— 一個自動化數據管道工具,能將散落各處的技術文件、Runbook、Postmortem 向量化,讓 kagent AI Agent 秒級查詢整個組織的知識資產,打造屬於你的「組織儲思盆」。
《哈利波特》裡鄧不利多有一件魔法古物叫做儲思盆(Pensieve):將記憶從大腦中抽出、存放其中,未來任何人都可以重新進入那段記憶、以旁觀者的視角重新審視每一個細節。
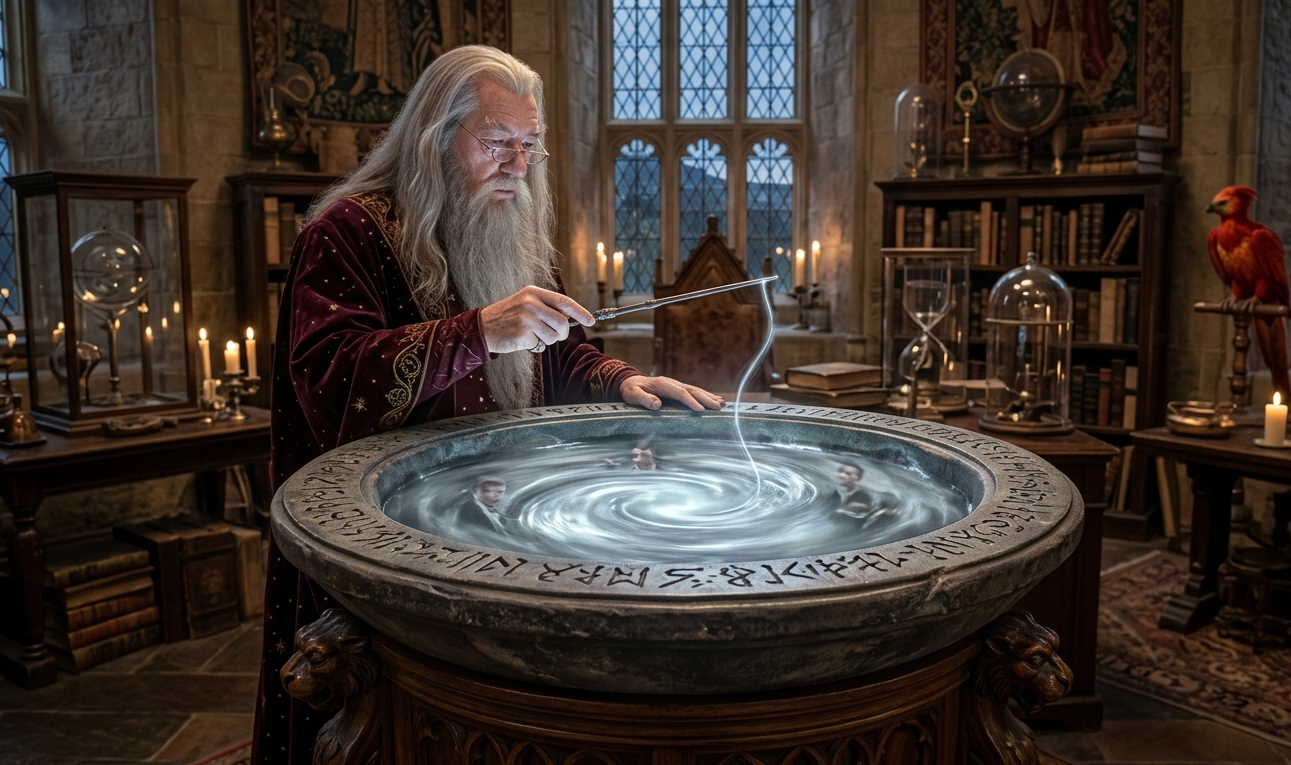
這個隱喻套用在工程組織上出奇地貼切。
每一次凌晨三點的事故處理、每一份精心撰寫的 Runbook、每一篇充滿血淚的 Postmortem —— 這些都是組織最珍貴的記憶。但它們散落在 Notion、GitHub、Slack 的各個角落,等到下一次同樣的事故發生,新人翻了 15 分鐘文件,還不一定找得到。
如果可以把這些記憶全部「倒進儲思盆」,讓 AI 隨時幫你翻出來呢?
這正是 kagent-dev/doc2vec 想解決的問題。
問題背景:知識的碎片化困境
一個成長中的工程團隊,知識往往分散在以下幾個地方:
| 知識類型 | 通常存放位置 |
|---|---|
| 操作手冊、架構文件 | Notion / Confluence |
| 事故記錄(Postmortem) | Google Docs / GitHub |
| 即時問答、決策紀錄 | Slack thread |
| 程式碼與 API 文件 | GitHub / README |
| 客戶 Q&A | Zendesk KB |
這種碎片化帶來兩個反覆出現的痛點:
「月經題(Recurring Questions)」:每個新人、每個輪值的 on-call 都會問同樣的問題 ——「Grafana Dashboard 連結在哪?」、「VPN 怎麼連?」、「這個 alert 代表什麼?」。這些問題不難,但每次都需要資深成員停下手邊的工作來回答,積少成多就是每週幾個小時的上下文切換成本。
「歷史情境消失」:一個半年前解決過的 PostgreSQL 連線池耗盡問題,當時的排查思路、臨時解法、根本原因都在 Postmortem 裡,但下次凌晨三點同樣的告警響起,新的 on-call 工程師從零開始。組織踩了同一個坑兩次,甚至三次。
doc2vec:組織知識的自動向量化管道
doc2vec 是 kagent-dev 開源的自動化數據管道工具(TypeScript 實作,Apache-2.0 授權)。它能自動抓取、清洗並向量化技術文件與代碼,建立 RAG(Retrieval-Augmented Generation)系統與語義搜尋所需的向量資料庫。
它可以 把你的文件庫「消化」成 AI 可以快速查詢的向量資料庫,讓 AI Agent 能在幾秒內找到跨文件、跨系統的相關答案,並附上出處。
技術深挖:它是怎麼做到的?
多元數據提取(Multi-source Ingestion)
doc2vec 支援六種資料來源,幾乎涵蓋現代工程團隊的所有知識載體:
| 來源類型 | 說明 |
|---|---|
website | 遞迴爬取文件網站,支援 Sitemap、PDF、JavaScript 渲染頁面 |
github | 抓取 GitHub Issues 與 Comments |
local_directory | 掃描本地目錄,支援 .md、.pdf、.docx、.doc |
code | 以 AST-aware 方式 chunk 程式碼(Tree-sitter 驅動) |
zendesk | 爬取 Zendesk 客服票與知識庫文章 |
s3 | 從 S3 Bucket(及相容服務)讀取文件 |
設定方式極為直白,以本地目錄為例:
sources:
  - type: 'local_directory'
    product_name: 'ops-runbooks'
    version: 'current'
    path: './runbooks'
    include_extensions: ['.md', '.pdf', '.docx']
    recursive: true
    database_config:
      type: 'sqlite'
      params:
        db_path: './ops-runbooks.db'
智慧上下文切分(Intelligent Chunking)
RAG 系統最常見的失敗模式是「答案在文件裡,但 AI 找不到它」—— 原因往往出在 chunking 策略不好。doc2vec 在這個問題上做了不少工:
Heading Hierarchy:每個 chunk 都記錄它在文件結構中的位置,例如 ["Installation", "Prerequisites", "Docker"],並在 chunk 開頭注入 [Topic: Installation > Prerequisites > Docker]。這樣當你搜尋「安裝」,即使關鍵字在子章節裡,也能被正確關聯到。
chunk_index + total_chunks:v2.0.0 引入的 chunk_index 欄位讓 AI Agent 知道「這個 chunk 前後還有更多內容」,並可以依序取得完整頁面進行重建(Page Reconstruction)。這解決了 RAG 系統中常見的「答案被截斷」問題。
多層次變更偵測(Multi-Layer Change Detection)
增量更新是 doc2vec 的工程亮點之一,四層機制讓後續同步幾乎不會重複浪費運算資源:
- Sitemap
lastmod檢查:若日期沒變,連 HTTP 請求都省了 - ETag HEAD 請求:有 Sitemap 卻無
lastmod的 URL,發一個輕量 HEAD 請求比對 ETag - 自適應降退演算法(Adaptive Backoff):遇到 HTTP 429(Rate Limit)自動降速,成功後緩慢提速,避免爆量又避免太慢
- Content Hash 比對:即使 ETag 沒變,也會比對實際 chunk 內容的 hash,確保內容層級的變更偵測
四層過濾後,只有真正「有更新」的頁面才會觸發重新 embedding,大幅降低 OpenAI API 呼叫成本。
向量儲存選項
| 選項 | 適用場景 |
|---|---|
SQLite(better-sqlite3 + sqlite-vec) | 輕量部署、單機、Demo 環境 |
| Qdrant | 生產環境、大規模文件庫、需要高效 ANN 搜尋 |
實戰示範:把 Runbook 變成 kagent 的「大腦」
我開源了一個 Demo 專案 kagent-doc2vec-demo,展示完整的端對端流程:
runbooks/ + post-mortems/
        │
        ▼  npx doc2vec config.yaml
  ops-runbooks.db
  incident-postmortems.db
        │
        ▼  docker build + push
  MCP Server image(內嵌 .db 檔案)
        │
        ▼  kubectl apply -f k8s/
  Kubernetes: Deployment + RemoteMCPServer + Agent CRD
        │
        ▼  kagent UI
「上次 PostgreSQL 連線池耗盡是怎麼處理的?」核心概念是:將向量資料庫打包進 Docker Image,透過 MCP(Model Context Protocol)協議暴露給 kagent Agent 使用。這樣 Agent 就擁有了「查詢內部文件」的工具,能直接在對話中引用 Runbook 與 Postmortem 的具體內容與出處。
場景一:新人無負擔提問
新進的 SRE 遇到事故,不需要打斷任何人,直接問 AI:
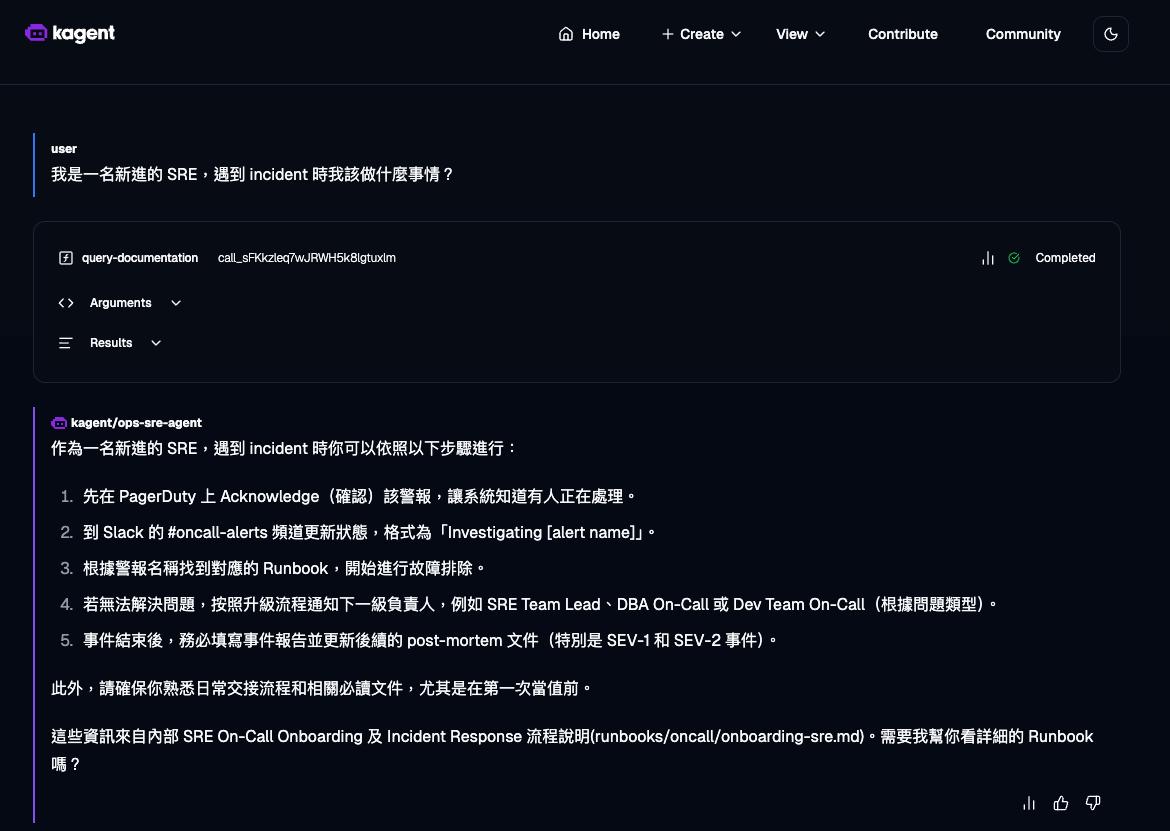
過去這類問題需要打 Slack 等人回答,或是翻文件找了半天找不到正確版本。現在 10 秒得到有出處的答案,降低新人的心理焦慮,也讓資深成員少被打斷幾次。
場景二:告別「月經題」
「公司的 Grafana Dashboard 連結是什麼?」這種問題每個新人都會問,每次都需要有人去找並回覆。
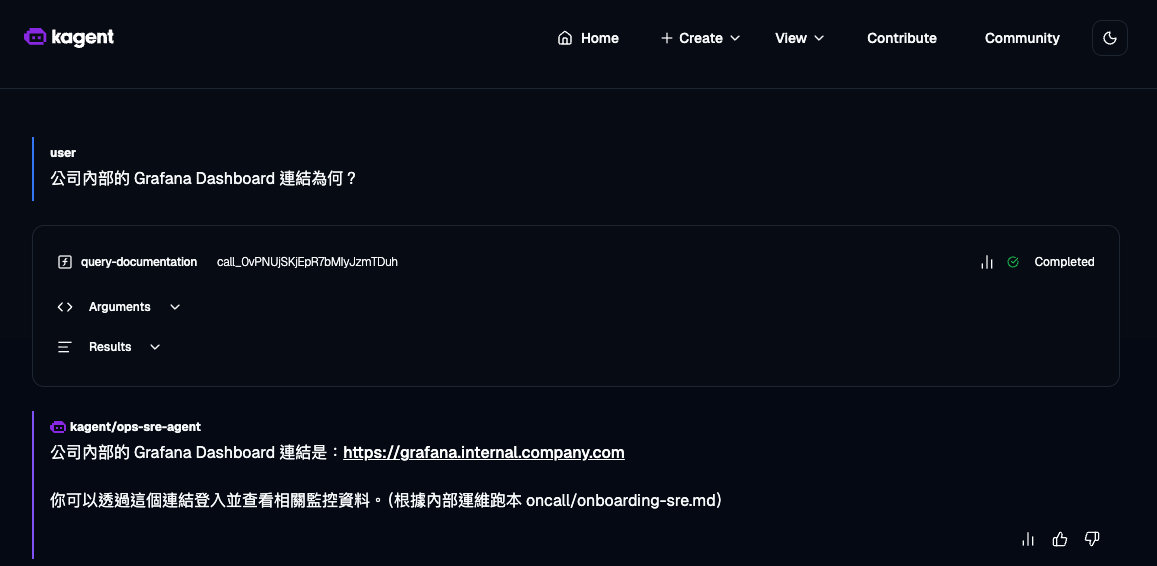
高頻但低複雜度的重複問題,交給 AI 統一精準回覆,解放資深工程師的時間去做更有價值的工作。
場景三:整合 Postmortem,讓歷史說話
凌晨三點,PostgresConnectionPoolExhausted 告警響起。工程師問 AI:「我們以前也發生過類似的事,幫我確認可能的原因。」
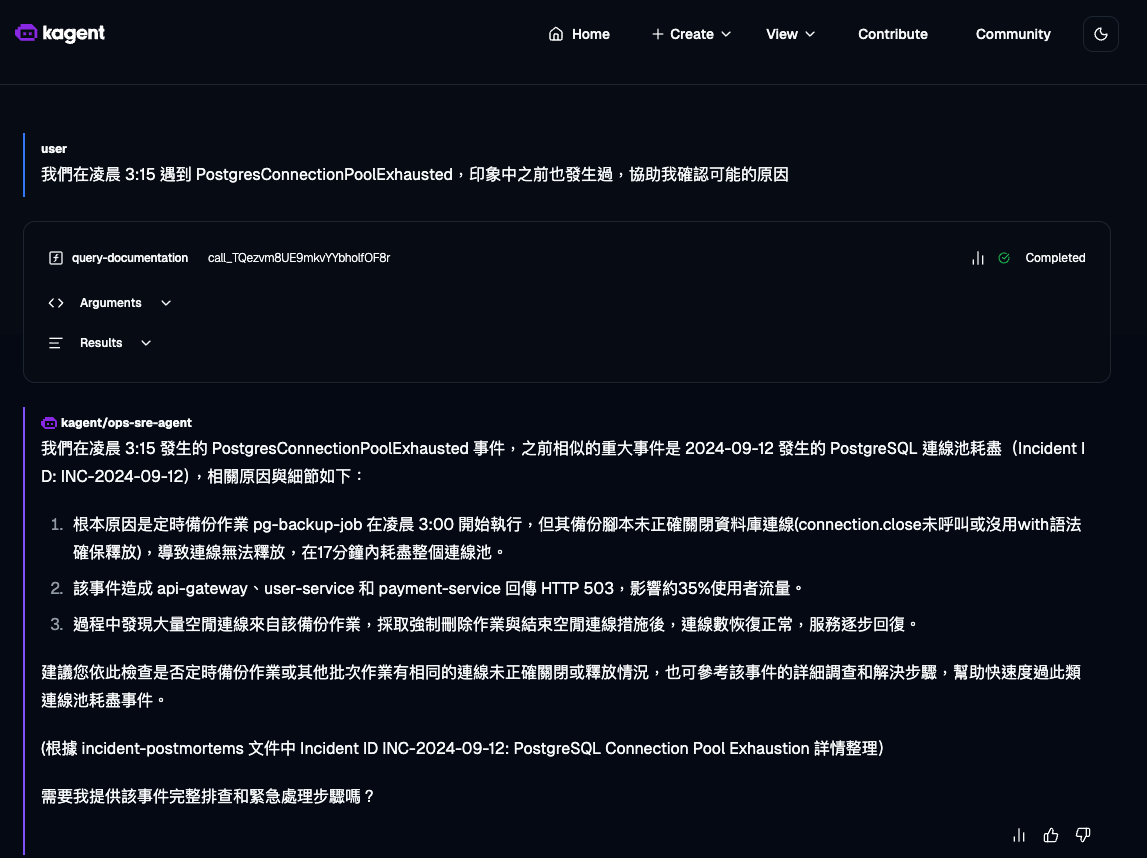
AI 從向量資料庫中找出 2024-09-12 發生的 PostgreSQL 連線池耗盡事件(Incident INC-2024-09-12),詳細說明根本原因(pg-backup-job 未正確關閉資料庫連線)、影響範圍,與當時的解決步驟。把組織的「踩坑血淚史」轉化為數位資產,快速找到解決方案。
場景四:整合 Runbook,現場提煉步驟
遇到 Pod CrashLoopBackOff,詢問 AI 應該怎麼辦:
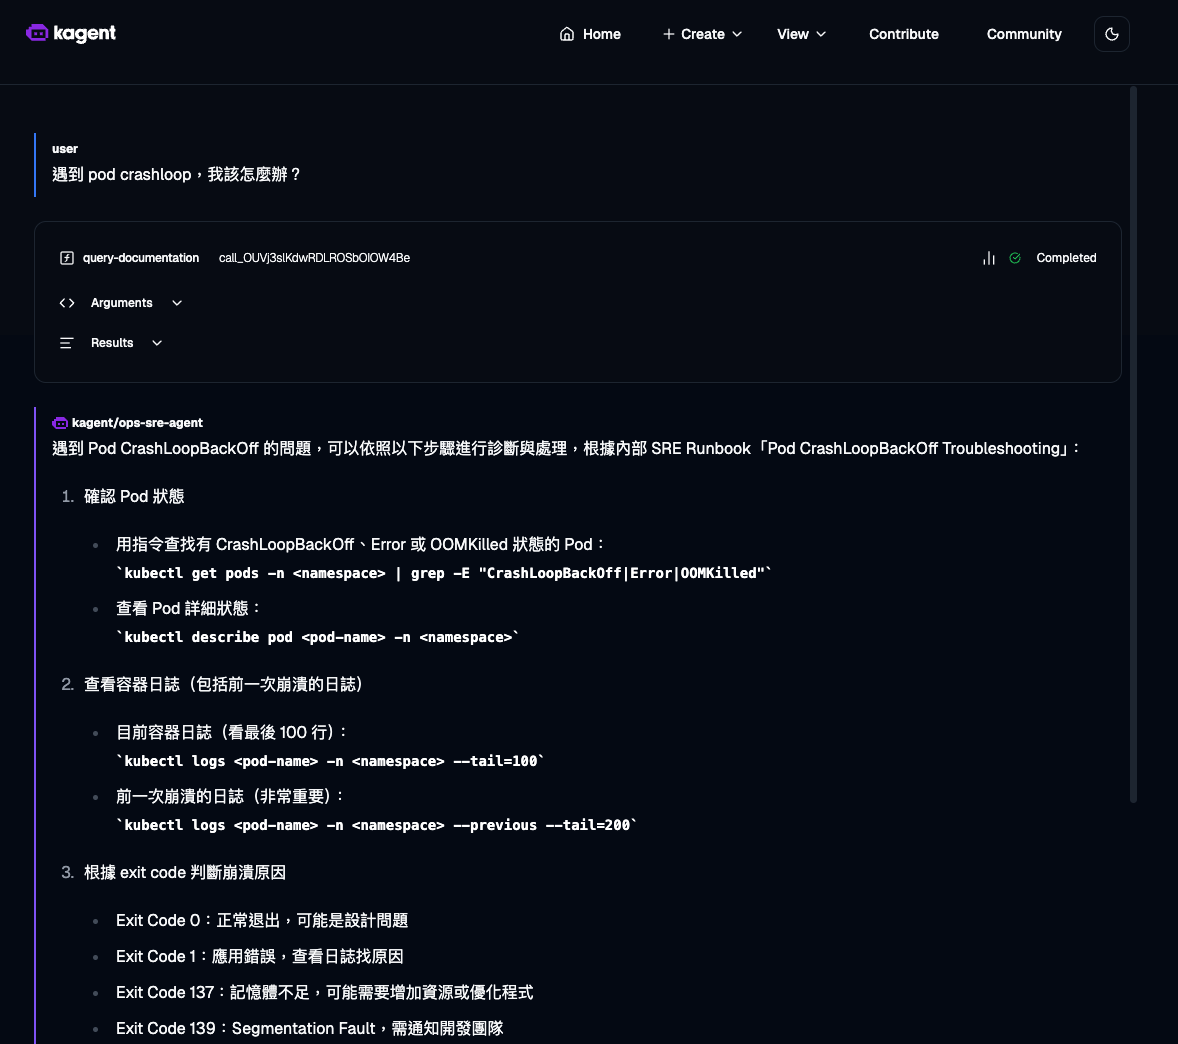
AI 直接引用內部 Runbook,按序給出 kubectl get pods、kubectl describe pod、kubectl logs 等診斷指令,把維運 SOP 化為即時引導。進一步還可以將這個查詢整合進 Agent Workflow,讓 Runbook 成為自動化排障流程的一部分。
知識資產的正向飛輪效應(Flywheel Effect)
「飛輪效應」這個概念來自管理學者 Jim Collins 的著作《從 A 到 A+》(Good to Great)。他用一個巨大的金屬飛輪做比喻:一開始推動它需要耗費巨大力氣,轉動很慢,但只要持續施力,每一圈都會把動能累積進去。到了某個臨界點,飛輪自己的重量與慣性就會帶著它持續加速,你施的每一份力都得到了比一開始大得多的回報。
doc2vec 最讓我著迷的地方不是技術本身,而是它所催化的組織行為正循環:
文件寫得越多 → AI 就越好用 → AI 越好用,大家就越有動力寫文件
過去大家不想寫文件,是因為寫了就像把石頭丟進海裡,看不到回報。寫完的文件沉在 Notion,找不到的人還是問人,寫的人也沒有成就感,甚至演變成交差心態,流於形式。
當文件被 doc2vec 向量化之後,每一篇 Runbook、每一份 Postmortem 都會立刻提升 AI Agent 的回答品質。工程師下次問 AI 問題時,如果得到了一個好答案,他會知道那是因為過去有人寫了好文件 —— 寫文件從「個人義務」變成了「對團隊數位大腦的投資」。
這個飛輪一旦轉動,知識積累會形成複利。
快速開始
安裝並執行 doc2vec
~$ npm install -g doc2vec

~$ npx doc2vec config.yaml
或直接 clone 並設定 config.yaml:
~$ git clone https://github.com/kagent-dev/doc2vec.git
~$ cd doc2vec
~$ npm install
~$ cp .env.example .env
# 填入 OPENAI_API_KEY
~$ npm start -- config.yaml
試用完整 Demo
kagent-doc2vec-demo 已將完整的 kind 本機部署流程封裝進 Makefile,幾行指令就能跑起來:
~$ git clone https://github.com/charles-hsiao/kagent-doc2vec-demo.git
~$ cd kagent-doc2vec-demo
~$ cp .env.example .env
# 填入 OPENAI_API_KEY
~$ make build-vectors   # 向量化 runbooks/ 與 post-mortems/,產生 .db 檔
~$ make kind-setup      # 建立 kind cluster、安裝 kagent、build image、deploy
make kind-setup 會依序完成:建立 kind cluster → 安裝 kagent → 建立 OpenAI API Key Secret → docker build → kind load → kubectl apply -f k8s/。完成後打開 kagent UI 即可對 ops-sre-agent 提問。
用完想清除環境:
~$ make kind-teardown本文所有截圖均以此 Demo Repo 完成。讀者可以直接照著上面的步驟跑起環境,再試著問出和截圖一模一樣的問題來驗證效果;也可以在
config.yaml中加入自己的資料來源,測試更貼近真實工作場景的查詢。
延伸思考
doc2vec 本質上是在解決一個更深層的問題:組織記憶的外化。知識資產長期以來有很大一部分鎖在「老手的腦袋裡」:幾年累積的系統直覺、踩坑經驗、那些「大家都知道但沒人寫下來」的潛規則。每當一個資深工程師離職,這些東西就跟著消失。
2026 年 3 月,Jack Dorsey 與 Sequoia 的 Roelof Botha 聯名發表了 From Hierarchy to Intelligence,提供了一個更銳利的視角來理解這個問題。他們的核心論點是:層級制度的本質,是一套資訊路由協議。從兩千年前羅馬軍團的「十人分隊 → 百人隊 → 大隊 → 軍團」,到現代企業的中階管理層,它們存在的根本原因只有一個:「個人的管理幅度(Span of Control)有上限」,所以你需要一層又一層的人來彙總資訊、傳遞決策。
他們的主張是:AI 是第一個真正能取代這個路由功能的技術。Block 正在構建的「公司世界模型(Company World Model)」是一個持續更新、機器可讀的組織全景,讓 AI 接替過去由中階管理層承擔的情境傳遞工作,讓第一線工程師不需要層層彙報就能取得足夠脈絡來做決策。
在傳統公司,管理者的工作是了解團隊正在發生的事,然後沿著層級上下傳遞這個脈絡。在一個工作產出已經機器可讀的公司,AI 可以持續地建立並維護這幅全景。
doc2vec 做的事,正是這個世界模型的基礎建設:把散落各處的文件、事故記錄、操作手冊,轉化為 AI 可即時查詢的向量資料庫。當 AI 能承擔資訊路由的工作,組織的智能就不再需要鎖在層級裡才能流動。
不過這個論述有一個前提:工作產出必須「機器可讀」,決策、討論、設計都要留下數位痕跡。如果一個團隊的知識主要活在口頭對話和白板討論裡,doc2vec 能做的就很有限。換句話說,在導入任何 AI 工具之前,更根本的問題是:你的組織有沒有把 context 與 decision 納入數位足跡的文化? 不只是 Runbook 與 Postmortem,還有「為什麼當時選這個方案、放棄了哪些選項」——這些 Why 比 What 更難復現,卻往往是下次面臨同樣取捨時最需要的資訊。沒有這個土壤,飛輪就沒有起點。doc2vec 能加速飛輪,但它造不出那股初始動力 —— 那仍然是人和組織文化的問題,不是工具的問題。
相關連結
- kagent-dev/doc2vec(開源專案)
- charles-hsiao/kagent-doc2vec-demo(完整 Demo)
延伸閱讀:【AIOps】Kubernetes 原生的 AI Agent 框架:kagent 完整解析
延伸閱讀:【A2A 系列 #1】從對話到協作:為何 A2A (Agent to Agent) 是 AI 演進的終局之戰?