【AIOps】o11y-bench:讓 AI Agent 在真實觀測環境中接受 SRE 考驗
Grafana Labs 推出的開源基準測試框架 o11y-bench,首次將 AI Agent 評估從「靜態問答」推向「動態事實校驗」:在真實運行的 Prometheus、Loki、Tempo 容器堆疊中出考題,用可觀測性數據庫的實際數據判定對錯,並以一致性得分揭示模型可靠性的真實底線。
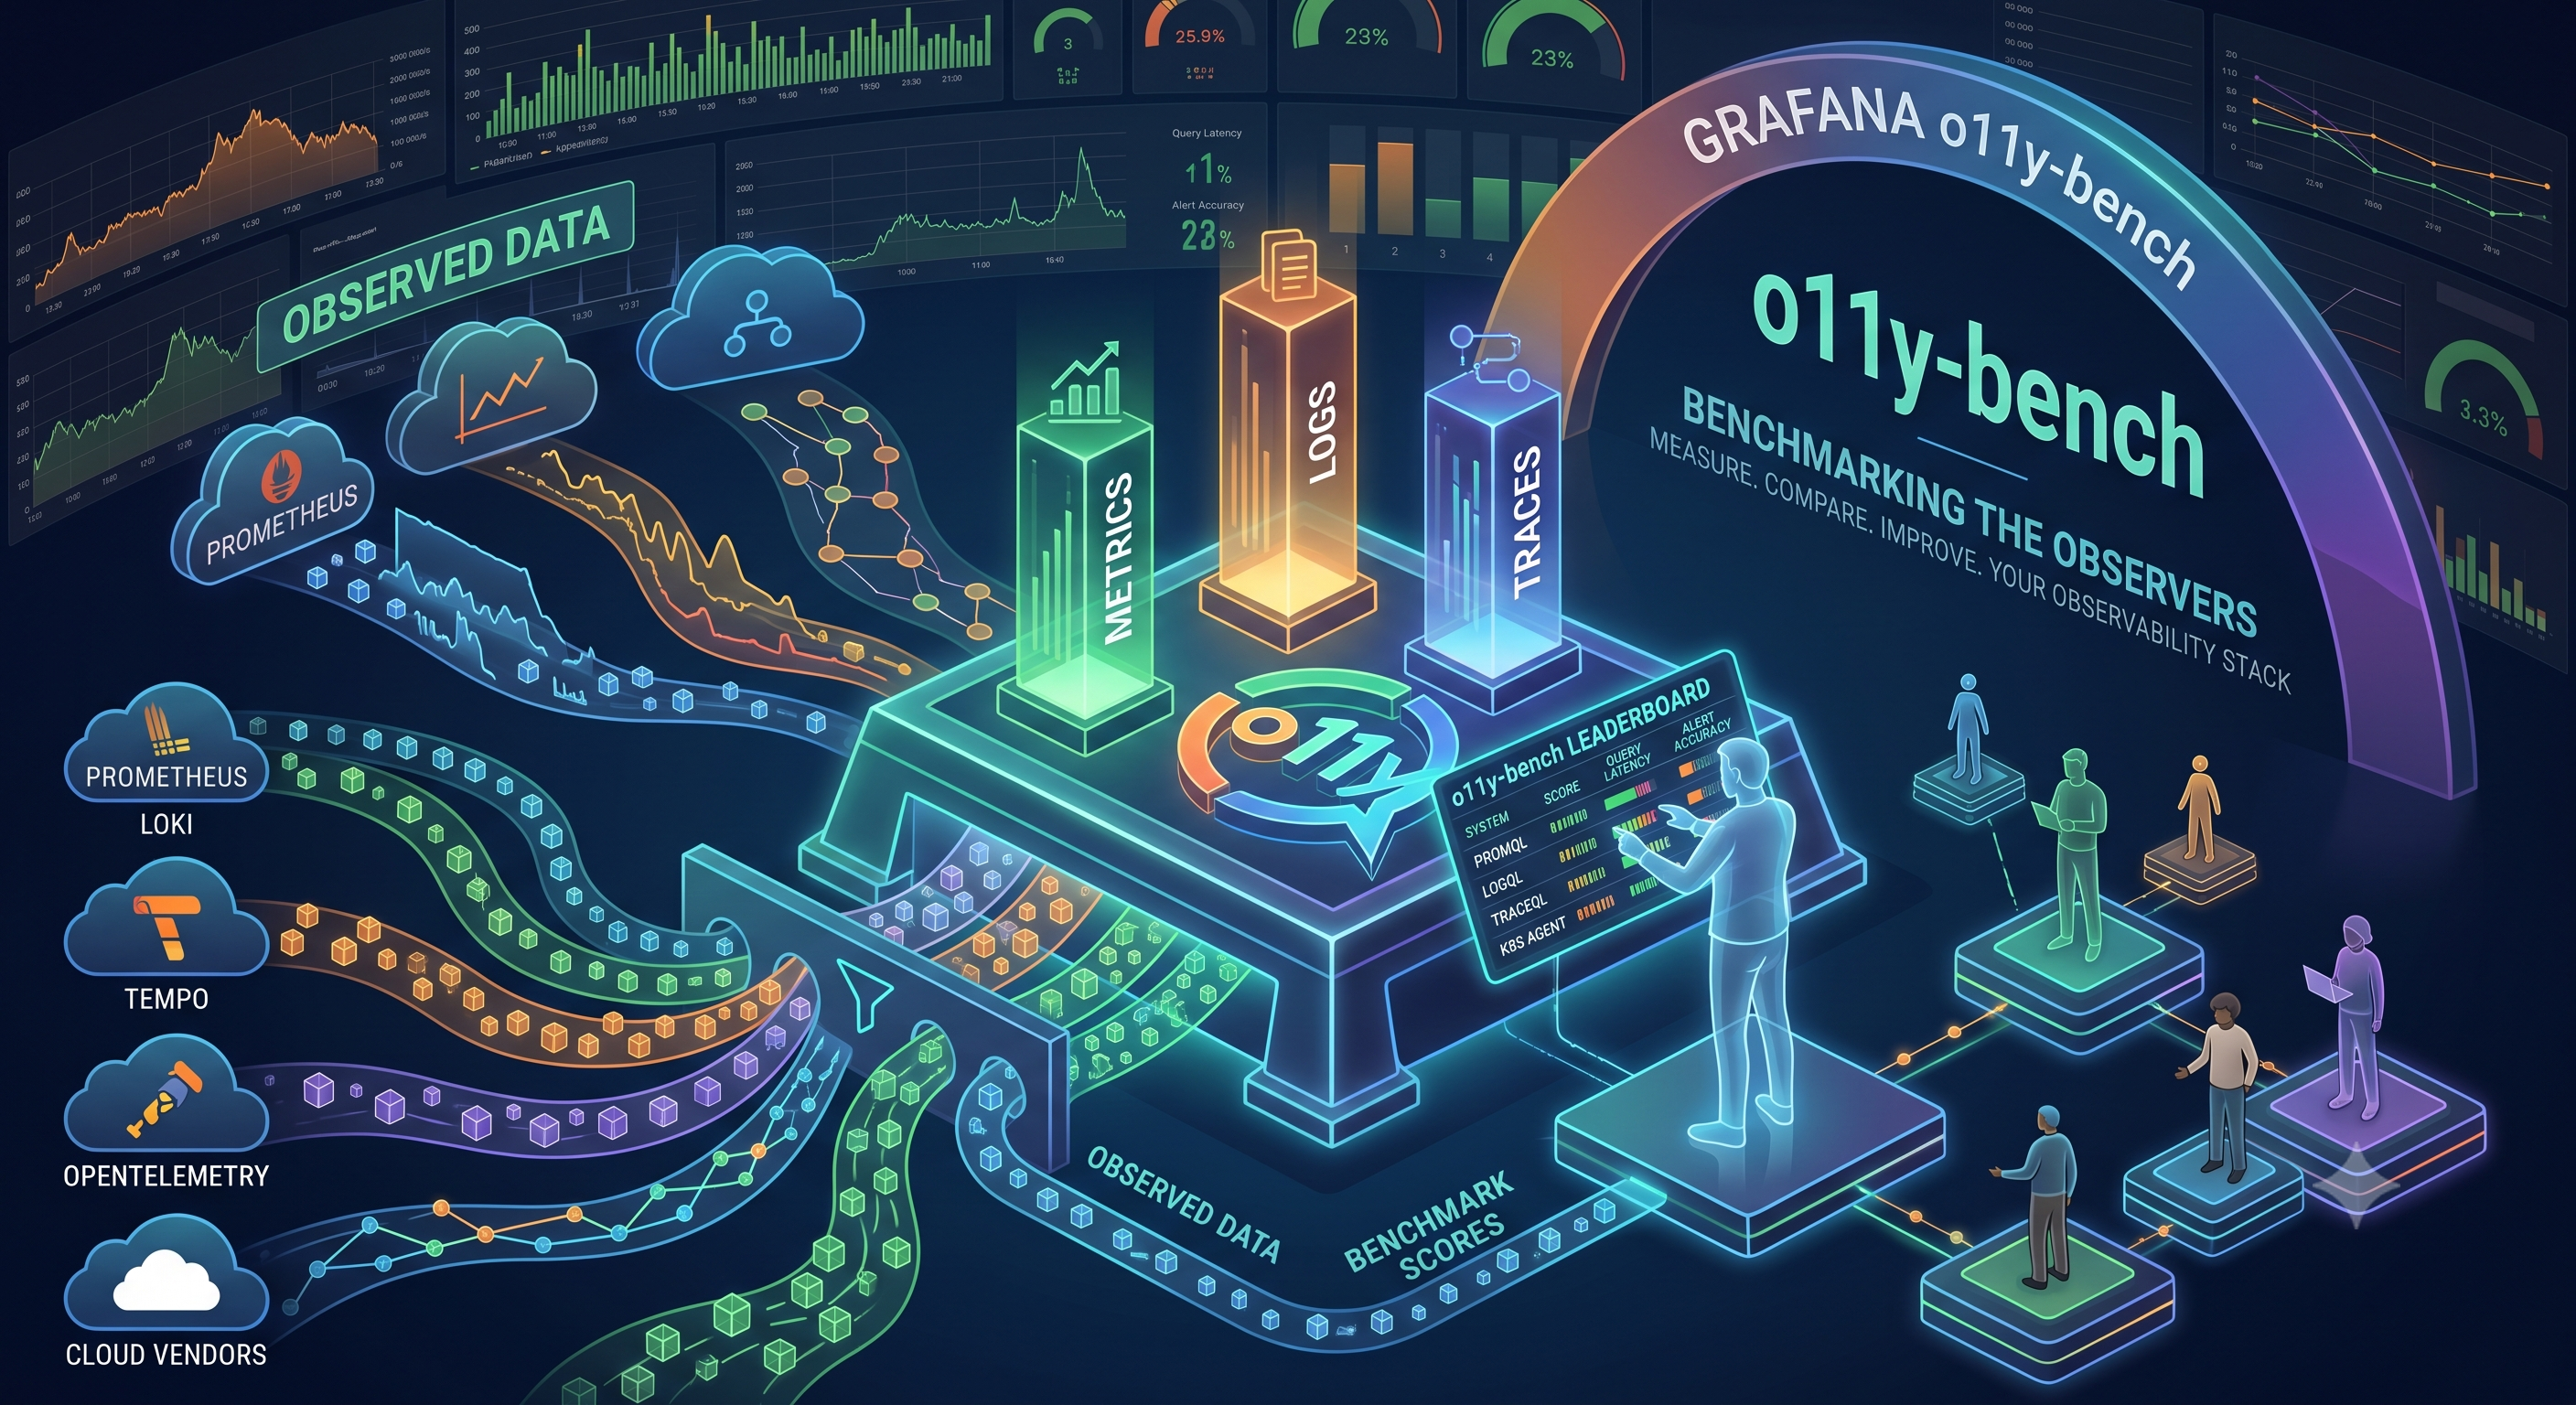
一個 LLM 能流暢地說出「p95 延遲異常可能是上游服務連線池耗盡所致」,不代表它能在凌晨三點的告警洪流裡,正確地執行一條 PromQL、從 Loki 撈出關鍵的重試錯誤日誌,然後給出一個數值準確的診斷報告。
「說得一口大道理」(aka 一本正經的胡說八道)和「能真正解決故障」是兩件完全不同的事。而在 o11y-bench 之前,整個 AI Agent 評估領域幾乎缺乏一把能區分這兩者的量尺。
問題根源:靜態基準測試與動態運維任務的本質落差
現有的主流 LLM 基準測試,設計邏輯大多建立在「給出文字輸入,評估文字輸出」的靜態模型上。這個模型在評估程式碼生成、數學推理或語言翻譯時相當有效,但面對可觀測性(Observability)與 SRE 任務時,它有三個根本缺陷。
第一,時效性問題:真實的監控指標是時間序列數據,它的查詢結果取決於你在什麼時間點發出查詢。一個靜態的「正確答案」無法對應一個隨時間漂移的指標集合。
第二,環境依賴性:SRE 排障是在真實系統中進行的行動,而非回答考題。AI Agent 必須知道如何與 Prometheus HTTP API 溝通、如何構成合法的 LogQL 語法、如何解讀 Tempo 返回的 Trace 結構。這些能力無法從文字問答中被測量——就像一張只有學科考試、沒有術科考試的駕照測驗,考生可以默背所有路牌含義,卻從未實際坐上駕駛座。
第三,驗證的客觀性:用「LLM-as-a-Judge(以大模型作為裁判)」評估診斷報告,是目前常見的折衷做法。它最大的問題是模型幻覺(Hallucination):一份語言流暢但數值錯誤的診斷,可能被另一個模型評為高分。
Grafana Labs 在 2026/04/21 推出的開源框架 o11y-bench 正是衝著這三個缺陷設計的(官方 Blog)。它不提供靜態題庫,而是在每次測試時運行一整套運行中的可觀測性容器 Stack,讓 AI Agent 對真實的監控數據庫發出即時查詢,再用同一份數據庫的實際數據來驗證答案。
架構核心:Harbor 框架與隔離容器環境
o11y-bench 的底層是 Harbor —— 一個專為 Agent 評估與強化學習環境設計的容器化沙盒框架。Harbor 的職責是為每一次評估任務建立完全隔離的運行環境,確保不同任務、不同模型之間的測試結果互不干擾/污染。
當一個評估任務啟動時,Harbor 會在背景同步拉起一整套Observability Sidecar Stack:
| 元件 | 職責 |
|---|---|
| Prometheus | 儲存注入的合成指標(Metrics)數據 |
| Loki | 儲存模擬故障場景的日誌(Logs)流 |
| Tempo | 儲存跨服務的分散式追蹤(Traces)鏈 |
| Grafana | 提供儀表板 API 端點,供 Agent 讀取與修改 |
這些容器中的遙測數據並非隨機產生,而是按照特定故障劇本精心注入的合成場景,例如佇列積壓、慢查詢、連線池耗盡等真實生產事故的重現。AI Agent 必須向這些正在運行的端點發出即時查詢,而非閱讀預先截取的文字日誌快照。
場景時鐘同步機制
時間序列數據有一個特殊挑戰:同樣一個 PromQL 查詢,在不同時間點執行會返回不同的結果。這使得「今天建立的測試案例,三年後能否重現相同結果」成為一個架構難題。
o11y-bench 的解法是場景時鐘同步機制(Scenario Clock Sync)。每個任務在初始化時都會生成一個靜態 ISO 時間戳記,寫入 scenario_time.txt。後續所有的代理執行與結果驗證,都以這個時間戳記作為時間窗口的錨點。這確保無論測試在何時重新運行,查詢的時間範圍始終對齊到同一份遙測數據,測試結果具備完整的長期可重現性。
雙軌制互動介面:MCP 協定與 gcx CLI
o11y-bench 支援兩種截然不同的 Agent 互動路線,而選擇哪一條,取決於你想讓 AI 扮演什麼角色。
MCP 模式是「對話驅動」的:LLM 透過語義化的工具名稱(例如 query_prometheus、get_dashboard)與系統溝通,工具的意圖對模型是透明的。Agent 能理解它在做什麼,因此適合需要多步驟推理的診斷任務——這是讓 AI 當值班工程師。
gcx 模式則是「狀態驅動」的:Agent 不需要逐步下指令,而是直接描述「我要的最終結果長什麼樣」,然後由 gcx 負責把 Grafana 的實際狀態調整過去——這跟 Kubernetes 的 YAML apply 是同一個概念。適合 CI/CD 流水線或 GitOps 場景,讓 AI 擔任自動化的配置管理員。
模型上下文協定(MCP)整合
框架原生整合了 Anthropic 主導的 Model Context Protocol(MCP,模型上下文協定),在後台同時運行 mcp-grafana 與 tempo-mcp-server 兩個 MCP 伺服器。這些伺服器將複雜的可觀測性 API 抽象為 LLM 可直接調用的語義化工具集,涵蓋超過 50 種標準化操作:
指標與日誌查詢:透過標準輸入輸出(stdio)傳輸管道,Agent 可直接執行 PromQL 與 LogQL 查詢,拉取即時指標與日誌。
分散式追蹤分析:tempo-mcp-server 使用 HTTP 傳輸協議與 SSE(Server-Sent Events,伺服器發送事件)機制,支援傳入 TraceQL 語法對調用鏈進行延遲與錯誤溯源。
上下文優化工具:Grafana 儀表板的 JSON 結構龐大,直接傳入 LLM 會迅速耗盡上下文窗口(Context Window)。MCP 工具集提供了 JSONPath 精準提取(例如 $.panels[*].title)與儀表板結構摘要生成,確保 Agent 取得必要資訊的同時,最小化 Token 消耗。
運維生命週期管理:Agent 具備列出、修改報警規則,以及建立儀表板、標註(Annotations)與事件響應(Incidents)的工具權限,使其能在診斷之後執行實質的緩解動作。
宣告式 Grafana Cloud CLI(gcx)互動模式
除了 MCP 之外,o11y-bench 亦支援基於 gcx(Grafana Cloud CLI)的工程化測試模式。gcx 是 Grafana 官方推出的開源命令行工具,讓使用者能夠透過 YAML 或 JSON 描述檔對 Grafana Cloud 資源進行版本控制與宣告式管理,目標是讓儀表板、報警規則、SLO 等配置像程式碼一樣可被 Git 追蹤與自動化部署。其底層架構借鑑了 Kubernetes 的宣告式設計(Declarative Design)(官方文件)。
gcx 從 Grafana v12 開始利用了一組與 Kubernetes API 風格相同的端點,讓 Agent 可以像執行 kubectl apply 一樣,對儀表板、報警規則、SLO(Service Level Objective,服務等級目標)與合成監測(Synthetic Monitoring)進行版本控制與批次同步,而不需要一個一個手動點 UI 操作。
在安全性上,gcx 支援在真正推送之前先跑 gcx validate,用預先定義的規則檢查配置有沒有問題,避免 AI 直接把壞掉的設定部署上去。
下表對比這兩種介面的技術特性與適用場景:
| 評估維度 | MCP 整合模式 | gcx CLI 互動模式 |
|---|---|---|
| 互動協議 | JSON-RPC over stdio 或 HTTP/SSE | CLI 二進位命令、JSON/YAML 輸出、標準結束碼 |
| 資源操作模型 | 命令式工具調用(Imperative Tool Calling) | 宣告式資源控制,相容 K8s /apis 端點 |
| 變更驗證 | MCP 伺服器端參數 Schema 校驗 | 本地 Rego 規則驗證、部署前靜態檢查 |
| 最適場景 | 語義化推理、故障診斷、交互式問答、多指標關聯 | CI/CD 整合、儀表板 GitOps、批次資源配置 |
63 個 SRE 任務場景:從單點查詢到跨系統事件調查
o11y-bench 目前包含 63 個基準測試任務,涵蓋五個核心運維領域,從基礎的指標查詢到高度複雜的多信號關聯調查:
Prometheus 與 PromQL 任務:測試 Agent 是否能在高負載或異常狀態下,正確編寫聚合函數並計算指標的歷史百分位數(Percentile)或速率。
Loki 與 LogQL 任務:檢驗 Agent 在數百萬行日誌中過濾、解析並提取關鍵錯誤模式的能力,特別是識別微弱的間歇性異常訊號。
Tempo 與 TraceQL 任務:要求 Agent 追蹤跨多個微服務的分散式調用鏈,定位造成端到端延遲異常增加的具體瓶頸節點。
多步驟事件調查(Incident Investigations):這是最接近真實值班(On-Call)工作流的任務類型。以 promql-retry-backlog-triage 任務為例,Agent 必須依序完成:偵測 Queue 裡面的 PromQL 告警、用 LogQL 挖掘重試失敗的資料庫日誌、再以 TraceQL 鎖定造成阻塞的慢查詢事務。這三個信號來自不同的遙測系統,每一步的結論都是下一步的輸入。
儀表板編輯與修復(Dashboard Repair):Agent 必須讀取損壞的儀表板配置,修復寫錯的變數綁定或無效的查詢語句,然後提交更新。驗證器會直接對修復後的面板執行實際查詢來確認結果。
這種任務設計直接對應 SRE 日常工作的真實複雜度:不是孤立的知識點考題,而是需要多工具鏈協同的連鎖推理。
基於真實環境數據的驗證機制
傳統以「LLM-as-a-Judge」評分的方式,存在一個根本缺陷:語言模型在評估另一個語言模型產生的文字時,對語氣流暢與表述邏輯的偏好遠高於對數值事實的校驗。一份措辭精確卻包含錯誤數字的診斷報告,很可能獲得高分。
o11y-bench 的驗證機制建立在完全不同的基礎上:直接查詢正在運行的環境,以實際數據(Ground Truth from Live Environment)作為裁判。
當 AI Agent 給出診斷結論(例如「系統在 10:15 的 p95 延遲為 2.3 秒」)時,驗證器不評估其文字表述。它執行與該任務預先綁定的基準查詢(Reference Queries),直接向沙盒中的 Prometheus 或 Loki 拉取同一時間點的真實數據。只有當 Agent 提及的具體數值、IP 位址、錯誤碼或服務名稱與底層遙測數據庫的真實狀態完全吻合,才判定診斷正確。
對於儀表板修復任務,驗證流程更為嚴格:驗證器調用 Grafana 狀態 API 提取被 Agent 更新後的面板 JSON,動態綁定測試變數,實際執行面板內的查詢語句,再與預期結果進行斷言比較。
這種驗證設計的核心哲學是:在可觀測性系統裡,對就是對,錯就是錯,語言的流暢度不是加分項。o11y-bench 這套機制,正是專門用來防止 AI 一本正經地胡說八道。
可靠性鴻溝:「偶爾答對」和「穩定答對」是兩件事
o11y-bench 用兩個互補的指標來描述一個 Agent 的真實表現,而不是只看一次的成績。
每個任務都會在完全隔離的環境中跑三次。一致性得分(Consistency Score) 是平台的主要排名依據:三次全對得滿分,兩次對一次錯得 2/3,三次全錯得零。它衡量的是「這個 Agent 在同樣的任務上,能不能每次都給出一樣的正確答案」。
相比之下,偶發成功率(Any-Pass Rate) 代表的則是:三次裡至少對過一次算不算?這個數字通常比一致性得分高出一截,兩者之間的差距就是「可靠性鴻溝(Reliability Gap)」。
舉個例子:一個頂尖模型可能在第一次跑 promql-retry-backlog-triage 任務時,剛好走對了推理路徑,給出正確的 PromQL 和日誌分析。但第二次它換了個方向,得出不同的結論;第三次又走到另一條岔路。偶發成功率看起來不錯,一致性得分卻慘不忍睹。
這個差距在 SRE 值班場景裡代表的是真實風險:凌晨三點告警響起,你需要的不是「有時候很準的 Agent」,而是「每次行為都可預期的 Agent」。愛因斯坦說過「上帝不會擲骰子」,但一個可靠性鴻溝過大的 AI Agent 偏偏就是在擲骰子——你永遠不知道這次它是在對的那一次,還是錯的那一次。(關於 Agent 評估方法論的深度討論,可參考 Anthropic 的評估實踐)
截至撰文時的排行榜快照
以下是截至 2026-06-07 的 o11y-bench 排行榜 前十名(以一致性得分排序):
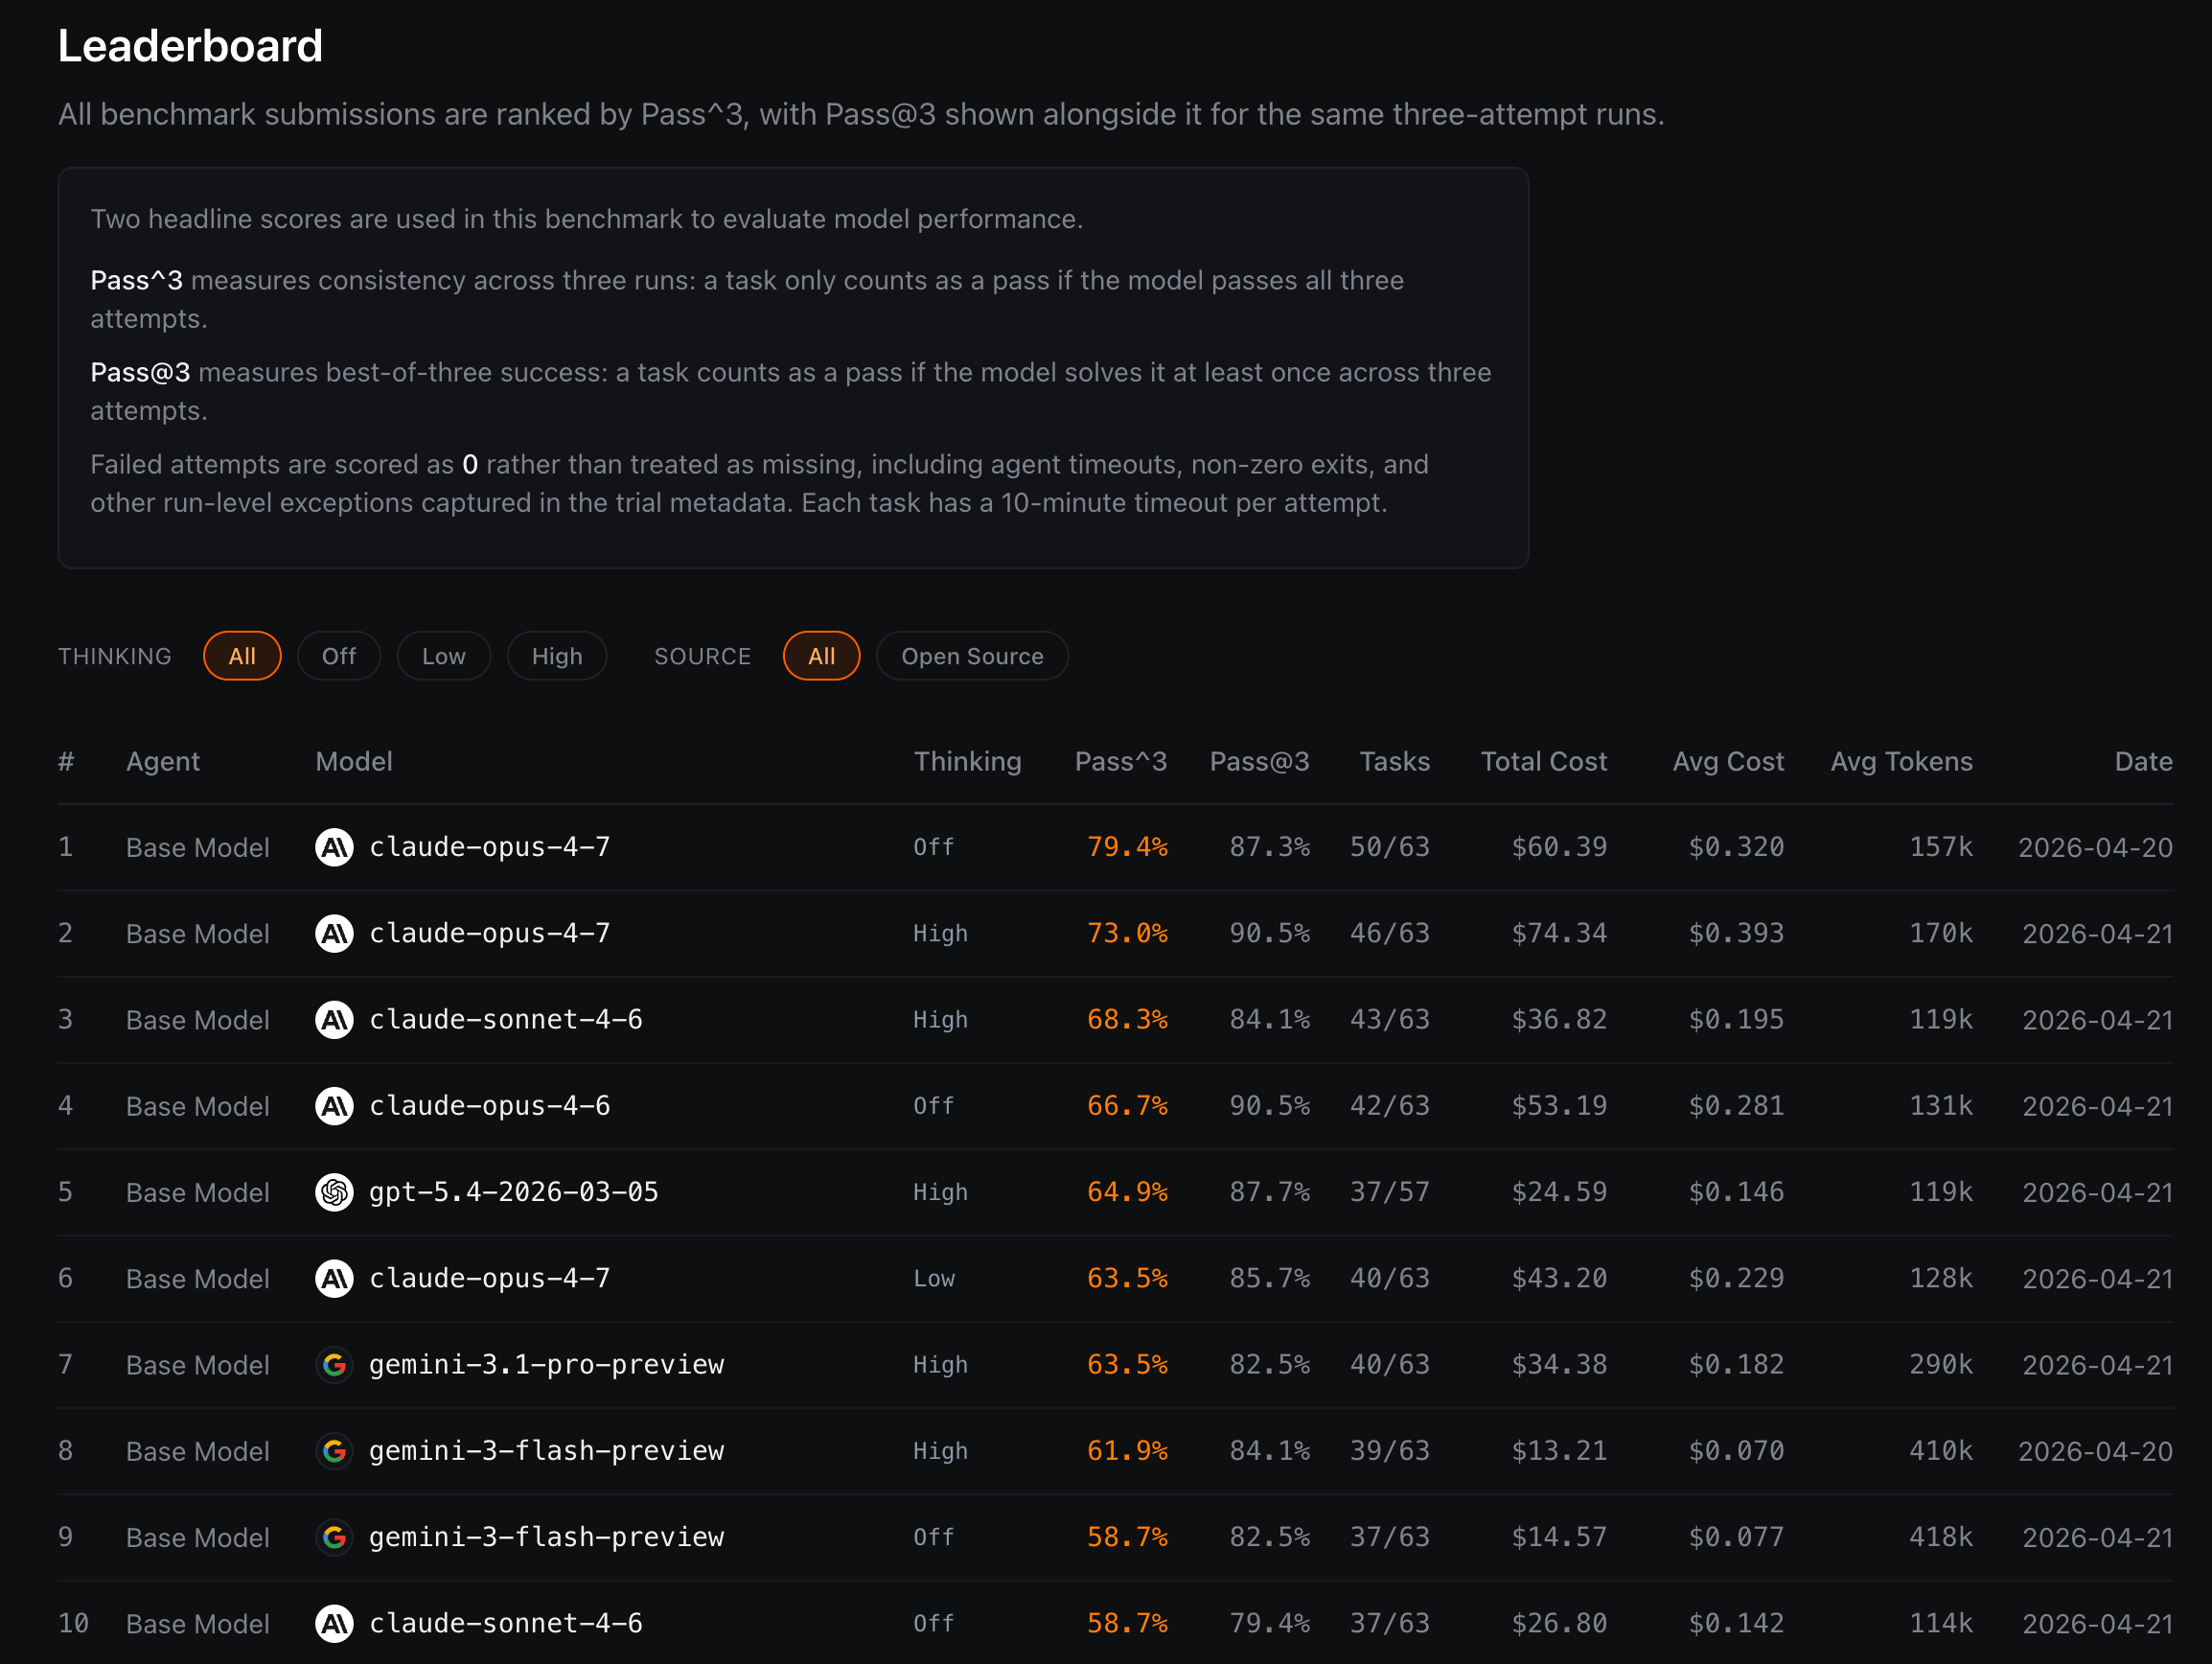 圖:o11y-bench 排行榜前十名(2026-06-07 截圖)
截圖中有兩欄核心指標,對應本文前述的兩個概念:Pass^3(即一致性得分)要求三次跑分全部通過才計一分,衡量「穩定性」;Pass@3(即偶發成功率)只要三次中有一次通過即計,衡量「上限」。排行榜預設以 Pass^3 排序,正是因為 Grafana 認為一個在生產環境有用的 Agent,必須能在同一任務上重複給出正確答案,而非靠運氣。
幾個值得注意的觀察:第一,目前榜單幾乎是 Anthropic、OpenAI 與 Google 三家閉源模型的天下,開源模型(最高排名為第 14 名的 qwen3.6-plus,一致性得分 55.6%)與頂尖閉源模型之間仍存在顯著差距。第二,Extended Thinking(延伸思考)並非總能提升一致性得分——第一名的 claude-opus-4-7 反而是在關閉延伸思考的情況下取得最高分,這暗示在工具調用密集的可觀測性任務中,過多的中間推理步驟可能反而引入了不確定性。第三,最高一致性得分僅 79.4%,意味著即使是當前最強的模型,仍有約兩成的 SRE 任務無法穩定完成,這正揭示這個領域的殘酷現實 —「可靠性鴻溝」。
開源模型整合與私有化部署
o11y-bench 底層透過 LiteLLM 對接各類語言模型,任何支援 OpenAI 相容 API 規範的推理引擎皆可接入——無論是 GPT、Claude 等閉源商業模型,還是透過 Ollama、vLLM 在私有環境自行托管的開源模型(Qwen、Llama、Gemma 等)。對於不希望將內部遙測數據送出至公有雲 API 的企業,這條私有化部署路徑提供了完整的評估能力。
執行時,o11y-bench 會自動建立隔離容器環境,收集 Agent 的指令執行軌跡(trajectory.json)與驗證結果(result.json),整套流程對閉源與開源模型一視同仁。
從評估工具到 AI-Native 基礎設施設計的啟示
o11y-bench 的存在本身傳遞了一個關於可觀測性工具設計的訊息:如果你今天設計的監控系統,其 API 讓 AI Agent 難以操作,那麼問題不在 Agent,在設計。
MCP 端點的原生支援、與 K8s 相容的宣告式 API、具備嚴格 Schema 與明確退出碼的 CLI 工具,這些不再是「選配」,而是下一代可觀測性基礎設施的基本要求。gcx 的設計已經在朝這個方向走,o11y-bench 則在為這個方向的工具提供客觀的能力量尺。
一致性得分與偶發成功率之間的可靠性鴻溝也揭示了一個更深層的研究方向:提升 AI Agent 的單次上限(讓它偶爾答對更難的題),與提升其執行一致性(讓它每次都能穩定完成基本的排障流程),是兩條截然不同的技術路徑。這就像評估一個外科醫生的標準:偶爾能完成高難度手術,和每次基本手術都零失誤,是兩件完全不同的事;前者讓人印象深刻,後者才讓你敢把命交給他。後者在生產環境中的價值遠高於前者,但目前大多數模型能力評估報告的關注重點仍然是前者。
然而,o11y-bench 的開源決策背後,有一層值得細讀的戰略邏輯。誰定義了基準,誰就定義了「夠好」的標準。 當整個產業開始用 o11y-bench 評估 AI Agent 在可觀測性任務上的能力,AI 研究者與工具開發者就會圍繞著 Prometheus、Loki、Tempo、Grafana 這套技術棧來優化模型——無論是微調訓練數據的選擇、工具調用的設計,還是 Prompt 的構成方式。這是一個精心構造的飛輪:基準測試越被廣泛採用,生態系對 LGTM 技術棧的熟悉度就越高;熟悉度越高,Grafana 工具在 AI-Native 基礎設施選型中的話語權就越強。
這不只是一個評估框架,更是 Grafana Labs 在 AI 時代插旗的方式——讓自己的技術棧成為 AI Agent 學習可觀測性的第一語言。
當 AI 能夠可靠地完成 SRE 的大部分日常診斷工作,工程師的核心價值會轉移到哪裡?可能不是「比 AI 更快找到故障根因」,而是「設計一個讓故障根因從一開始就顯而易見的可觀測性架構」——以及「制定一套能客觀衡量 AI 可靠性的評估標準」。o11y-bench 量化的,正是這條路上我們目前走到哪裡的座標;而 Grafana 選擇開源這把量尺,是因為它深知:定義遊戲規則的人,往往比贏得單場比賽的人走得更遠。
說到這裡,容我分享一個小小的巧合。
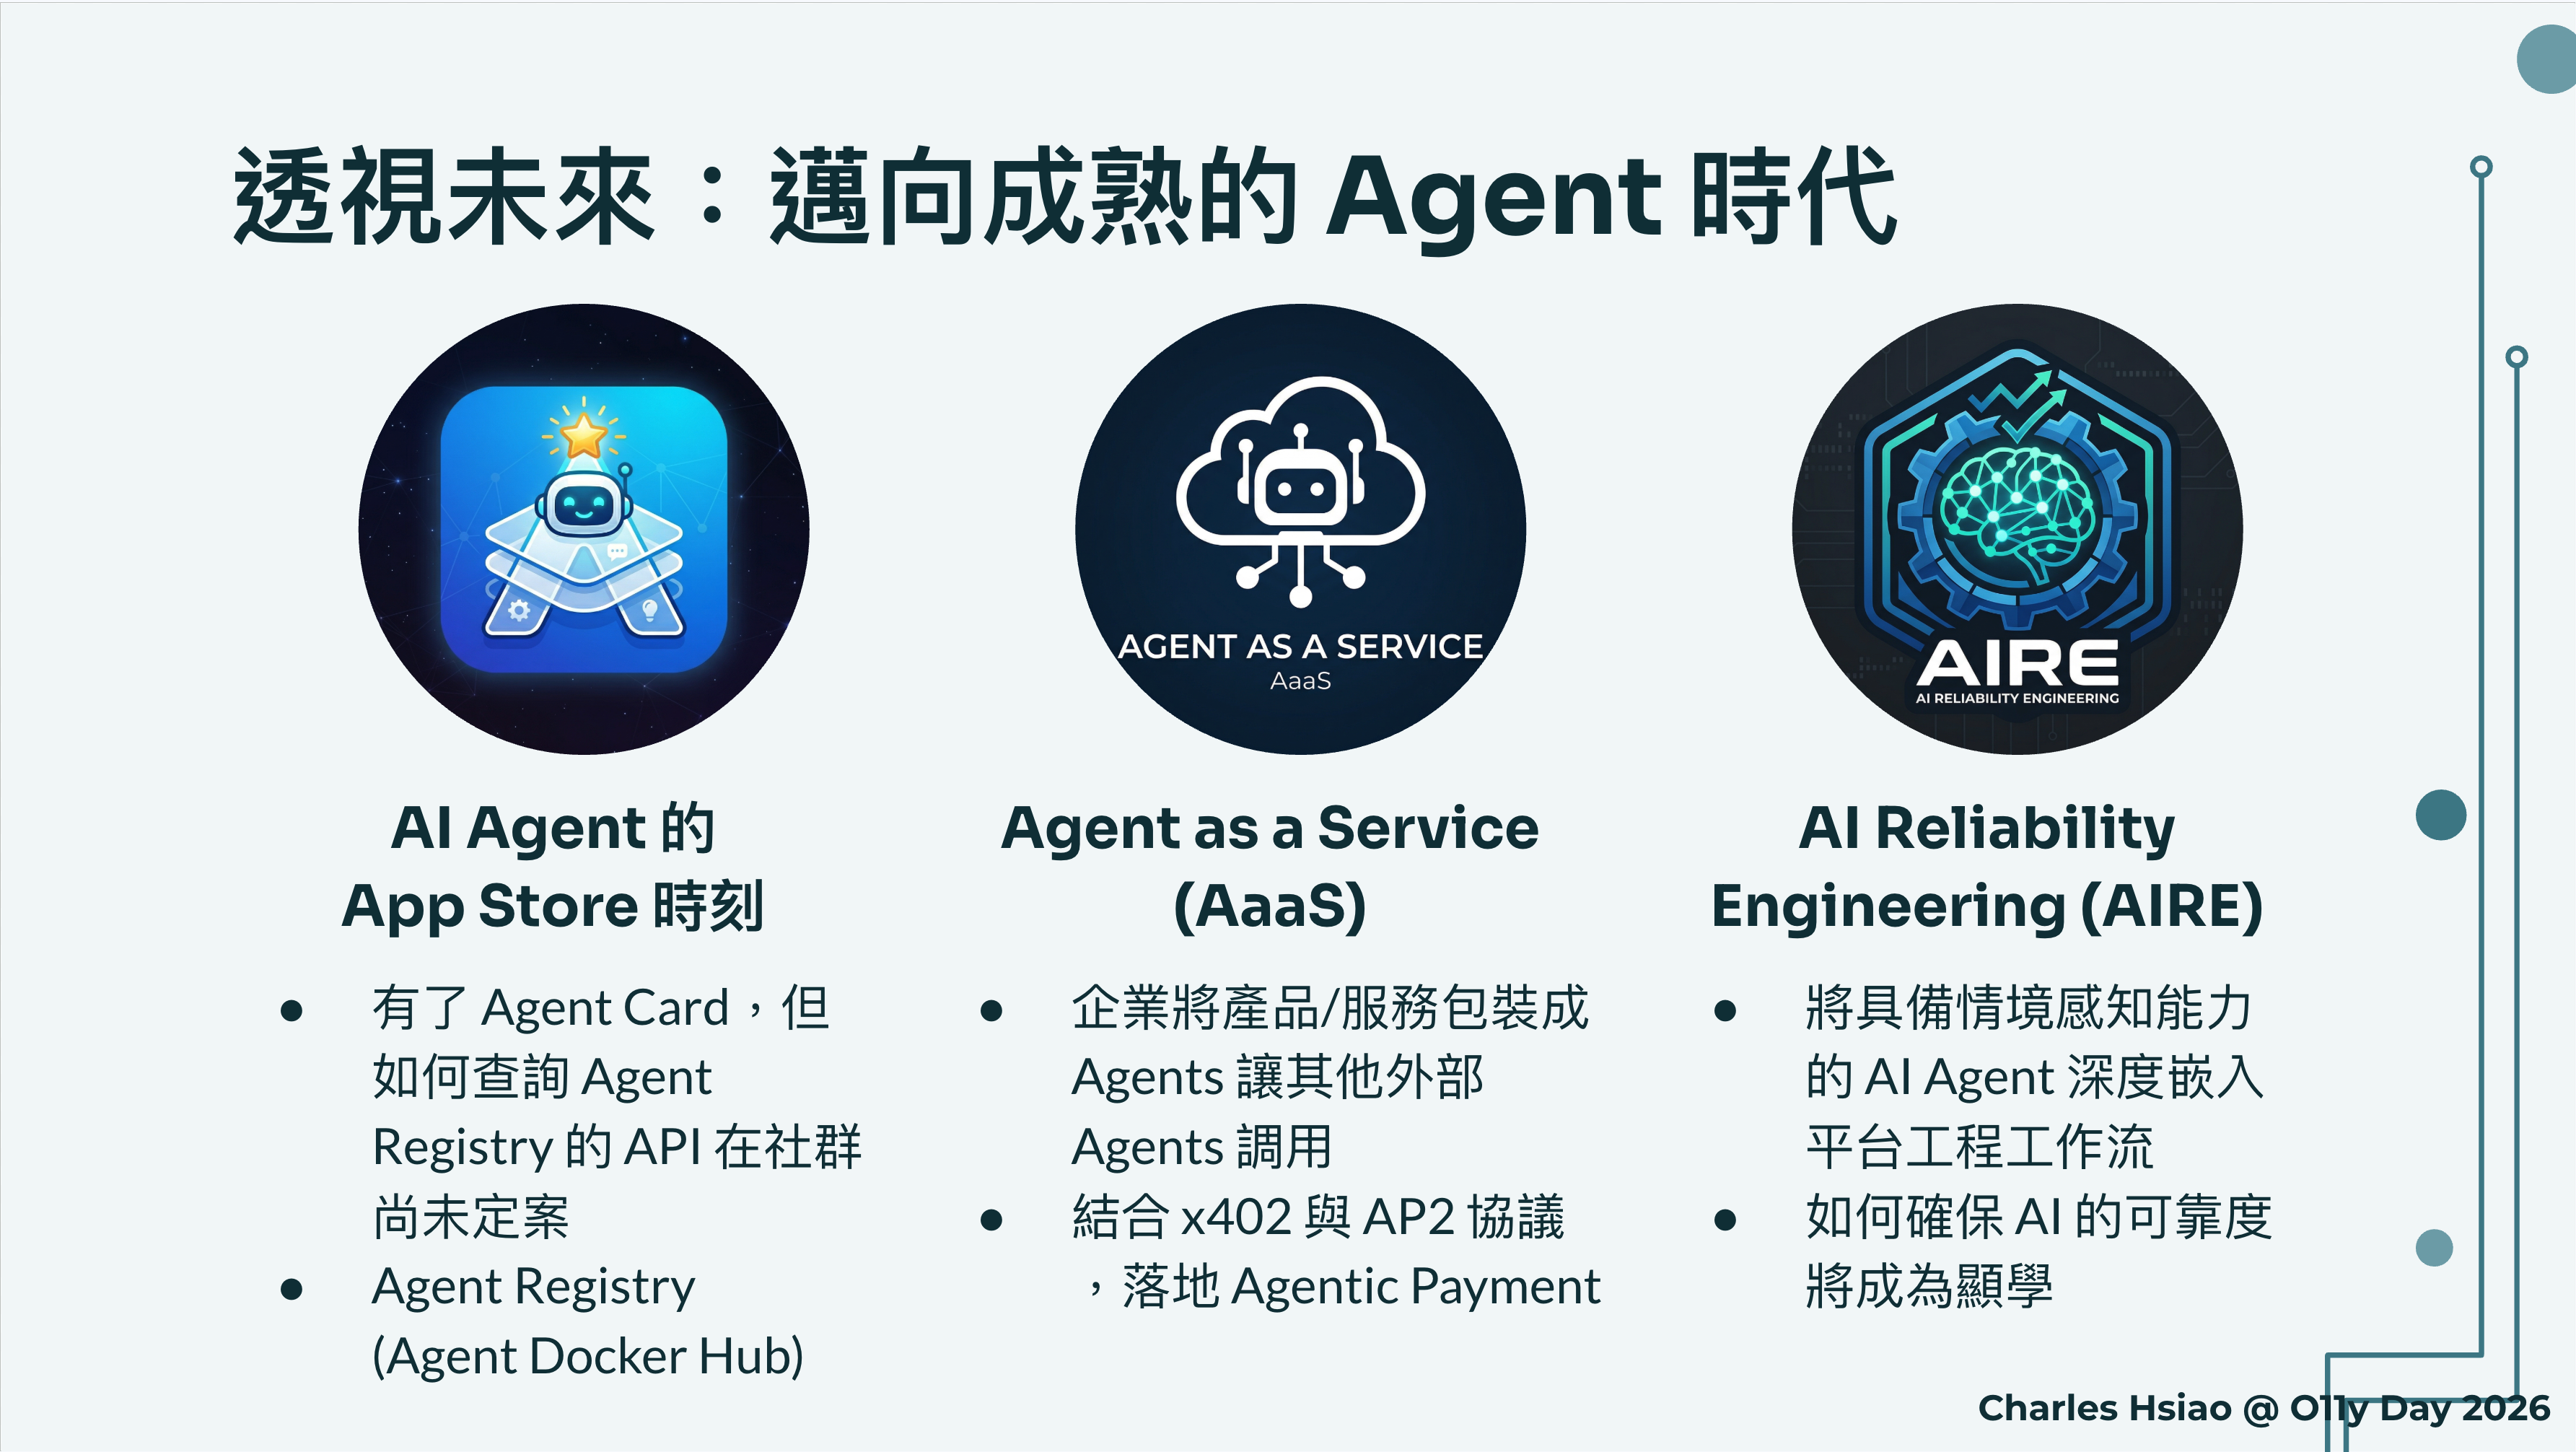 圖:2026/04/23 Observability Day 演講最後一頁投影片
2026/04/23,我在 Observability Day 2026 的演講最後一張投影片上寫下了這樣一個預測:AIRE(AI Reliability Engineering,AI 可靠性工程)將成為顯學——因為唯有 AI 足夠可靠,企業才會真正願意將 AI 大規模導入 Production 環境。而 Grafana Labs 正是在兩天前的 04/21 推出了 o11y-bench。當時我並未注意到這個專案,直到後來才看到。我不敢說這是什麼神奇的預判,但至少說明了一件事:這個問題,確實到了該被認真對待的時候了。
延伸閱讀:【AIOps】從救火員到建築師:SRE 如何演進為 AI 可靠性工程(AIRE)?