【Agent-Native Web】我給網站寫了一份說明書,然後 AI Agent 真的讀懂了
把個人網站的 Agent Skill Index 放上去之後,一個真實的問題浮現:Agent 真的會去讀那份說明書嗎?這篇用 Google ADK Python 寫了一個驗證專案,從靜態 Skill 定義到 Agent 真實呼叫,跑完完整的閉環。
上一篇文章把個人網站從 33 分改造到 Agent-Native 滿分,其中最有趣的一環是 Agent Skills Index —— 一份放在 /.well-known/agent-skills/index.json 的技能目錄,教 AI Agent 如何與這個網站互動。
延伸閱讀:【Agent-Native Web】SEO 時代結束了,你的網站 Agent Ready 了嗎?
但規格好看,不代表能用。一份 JSON 文件放在伺服器上,到底有沒有辦法讓 Agent 動態讀取、動態學習、然後真的去呼叫?
這篇用 Google ADK Python 寫了一個驗證專案,親手跑完整個流程 —— 從讀取 Skill Index,到真實的對話互動。
這個網站有哪三個 Agent Skill
在說明驗證怎麼跑之前,先說清楚「說明書」裡寫了什麼。我在這個網站放了三個 Agent Skill,這三個 Skill 各司其職,覆蓋了一個內容型個人網站最常見的 Agent 互動情境:
1. markdown-negotiation:驗證 Markdown 支援
SKILL.md 教 Agent 如何確認一個網站是否支援 Accept: text/markdown Content Negotiation:
- 對目標 URL 發送帶有
Accept: text/markdownHeader 的GET請求 - 確認回應的
Content-Type是否為text/markdown - 可選:呼叫
isitagentready.com的掃描 API 取得完整評分
這個 Skill 設計上是一個「工具 Skill」—— 它的受眾不只是要讀懂這個網站的 Agent,而是任何需要驗證 Agent-Native Web 合規程度的 Agent。
2. content-retrieval:搜尋與讀取文章
SKILL.md 定義了兩個操作:
- 取得最新文章列表:
GET /rss.xml,取回所有文章的標題、摘要、標籤、URL。因為沒有伺服器端搜尋 API,Skill 明確告訴 Agent「自己在 RSS 的 XML 中用關鍵字過濾」 - 讀取特定文章全文:
GET /blog/{slug}/,取回完整文章頁面。搭配 Markdown Content Negotiation,Agent 會拿到乾淨的 Markdown,而非 HTML
這個 Skill 讓 Agent 不需要搜尋引擎就能回答「最近寫了什麼」、「有沒有關於 Kubernetes 的文章」這類問題。
3. author-identity:查詢作者背景
SKILL.md 提供作者的結構化資料:
- 專業背景與技術棧(SRE、Kubernetes、AI Ops 等)
- 歷年演講記錄(
GET /talks/) - 聯絡方式(Email、GitHub、LinkedIn)
當使用者問「這個部落格的作者是誰、專長是什麼、怎麼聯絡他」,Agent 不需要爬 About 頁面 —— Skill 裡已經有結構化的答案。
問題意識:Agent Skill 不能只是靜態文件
傳統的 API 文件是寫給人看的 —— 工程師讀完 OpenAPI spec,手動接入 SDK,測試,部署。這個流程最短也要幾小時。
Agent Skill 的設計目標截然不同:讓 Agent 在執行期自動發現技能、理解技能、然後呼叫技能。沒有人類作為中間人。
isitagentready.com 的評分框架只告訴你「你有沒有發布技能索引」,但沒有告訴你「這個技能索引有沒有辦法被真實的 Agent 框架使用?」,這是我想驗證的問題。
工具選擇:Google ADK
ADK Python 是什麼
Google ADK(Agent Development Kit) 是 Google 開源的 Python Agent 框架,設計目標是讓開發者能用最少的程式碼建構、測試、部署 AI Agent。
幾個核心概念:
- Agent:具備目標的執行單元,背後由 LLM(如 Gemini)驅動,能自主決策要呼叫哪些工具
- Tool(工具):Agent 可以呼叫的函數。ADK 提供
FunctionTool,只需傳入一個 Python 函數,框架自動處理 JSON schema 生成與 LLM 的工具呼叫協議 - Runner:負責管理對話狀態、串接 LLM 與 Tool 的執行循環
adk web:內建的瀏覽器 UI,啟動後可以直接在網頁介面與 Agent 對話,適合快速驗證與展示
ADK 特別適合這個驗證場景的原因:
- ADK 是目前對 Agent Tool 概念支援最完整的 Python 框架之一,
FunctionTool的抽象層正好對得上 Web Skill 的 HTTP 呼叫模型 —— 每個 Skill 對應一個 Tool - 它有
adk web介面,可以直接在瀏覽器中與 Agent 互動,方便測試 - 框架的設計鼓勵動態組裝 Tool 列表,與「在啟動期讀取 Skill Index 再轉換成 Tool」的需求完全吻合
專案架構:python-web-skill-adapter-adk
原始碼開源於 https://github.com/charles-hsiao/python-web-skill-adapter-adk。
步驟如下:
- 讀取設定中的目標 Domain
- 抓取 /.well-known/agent-skills/index.json
- 解析每個 Skill 定義(名稱、描述、端點、參數)
- 把每個 Skill 轉換成一個 ADK Tool
- 啟動一個帶著這些 Tool 的 ADK Agent
只要換一個 WEB_SKILL_DOMAIN,Agent 啟動時就自動載入那個網站的所有 Skill。
目錄結構
python-web-skill-adapter-adk/
├── docs/
├── web_skill_adapter/
│   ├── __init__.py
│   ├── agent.py          # ADK Agent 初始化,組裝 Tool 列表並啟動 root_agent
│   ├── cli.py            # 本地 CLI 介面
│   ├── config.py         # 環境變數設定(WEB_SKILL_DOMAIN、MODEL 等)
│   ├── discovery.py      # 抓取並解析 /.well-known/agent-skills/index.json
│   ├── dynamic_tools.py  # 將 SkillSpec 轉換為 ADK BaseTool
│   └── models.py         # 資料模型(SkillSpec、SkillCatalog)
├── .env.example
├── pyproject.toml
└── README.md
Get Started
export WEB_SKILL_DOMAIN=www.charles-hsiao.com
export GOOGLE_API_KEY=your-api-key

uv run adk web
uv run adk web 會在本地啟動一個 Web UI,預設監聽 localhost:8000,可以直接在瀏覽器中對 Agent 發問。
Demo 流程:從一個問題到真實的內容
以下是三個實際執行的 Demo,分別驗證三個不同的 Skill。
Demo 1:驗證 Markdown Content Negotiation
對話從「你能幫我做什麼?」開始。Agent 啟動後自動讀取 Skill Index,直接回答自己具備哪些能力(因為能力清單就寫在 /.well-known/agent-skills/index.json 裡)。
確認能力後,用戶接著發起驗證。
用戶問:「Validate markdown content negotiation」
Agent 詢問 URL,用戶提供 www.charles-hsiao.com,Agent 呼叫 markdown-negotiation Skill 的驗證工具,對目標 URL 發送帶有 Accept: text/markdown Header 的請求,確認伺服器是否正確回應。
web_skill_markdown_negotiation_valida → HTTP GET (Accept: text/markdown) → pass結果:
The website https://www.charles-hsiao.com successfully supports Markdown content
negotiation. The check shows a "pass" status for markdownNegotiation, indicating
that the site supports Markdown for Agents.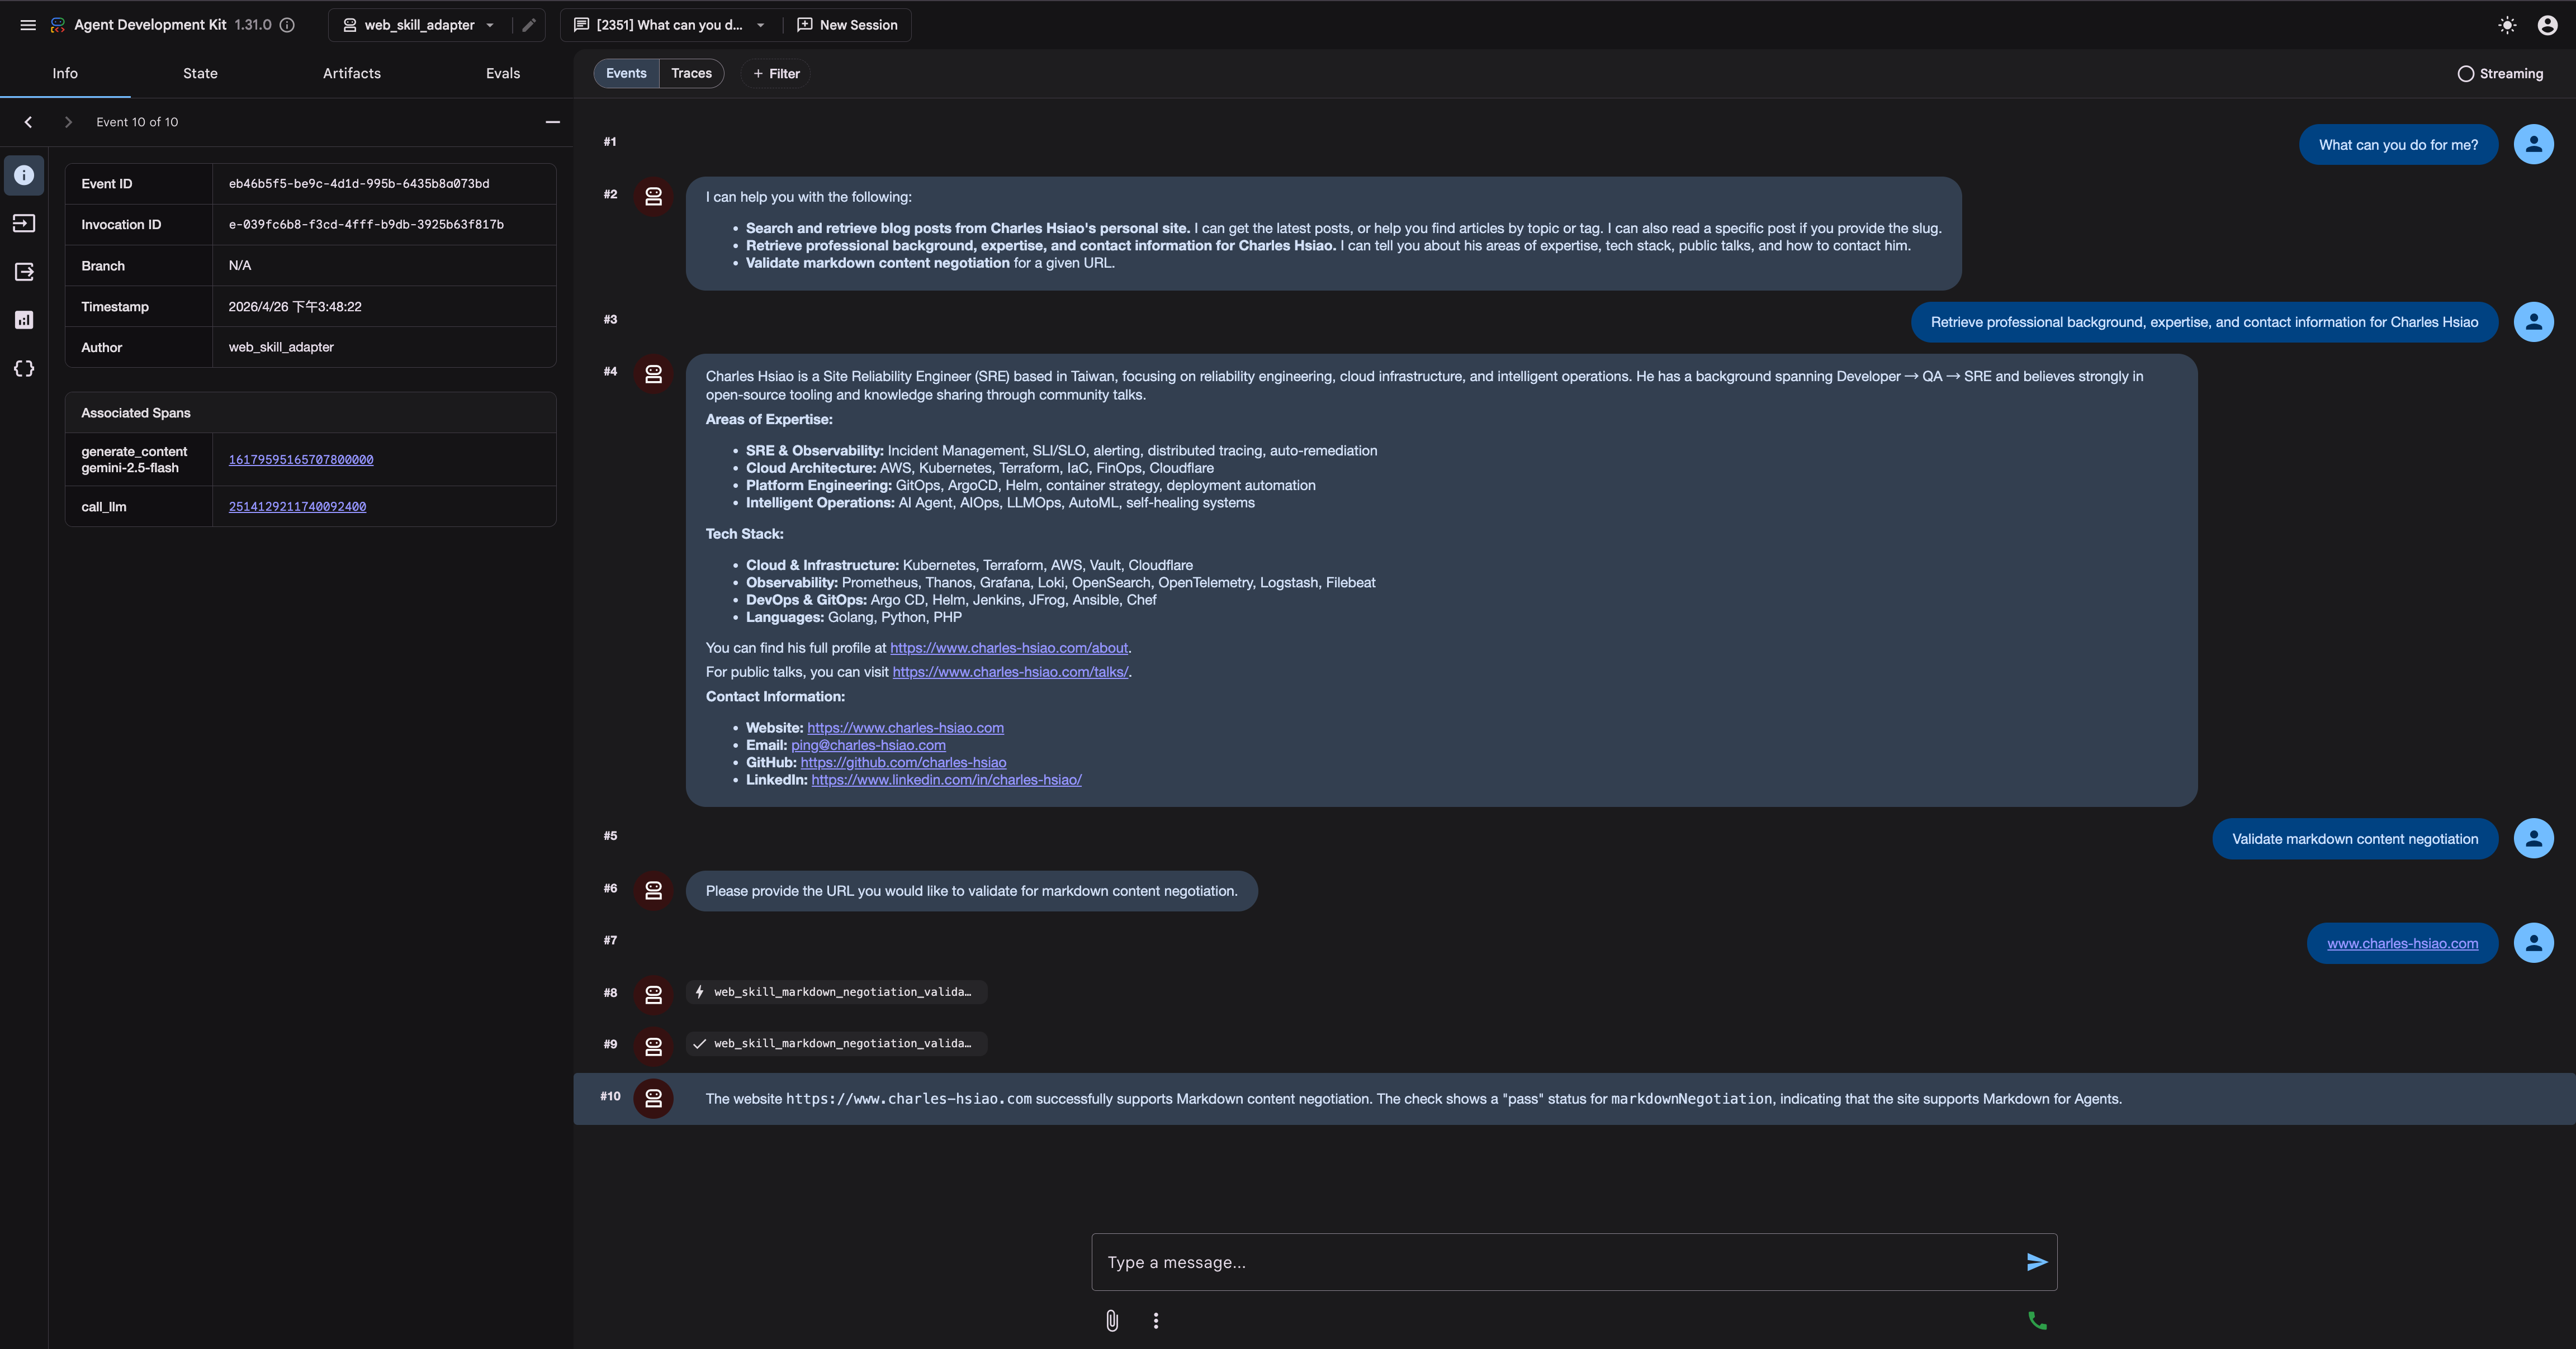
Demo 2:搜尋部落格文章
用戶問:「Search for blog posts discussing agentic payment.」
Agent 沒有伺服器端搜尋函數可用,但它知道可以呼叫 content-retrieval Skill 中的 get_latest 工具取得完整文章列表,再自行篩選。
web_skill_content_retrieval_get_latest → RSS Feed返回結果後,Agent 從標題和描述中識別出三篇相關文章:
| 篇名 | 連結 |
|---|---|
| 【Agentic Payment 系列 #1】HTTP 402 … | /blog/202604-agentic-payment-stack-part1/ |
| 【Agentic Payment 系列 #2】信任代理… | /blog/202604-agentic-payment-stack-part2/ |
| 【Agentic Payment 系列 #3】兆美元賽道… | /blog/202604-agentic-payment-stack-part3/ |
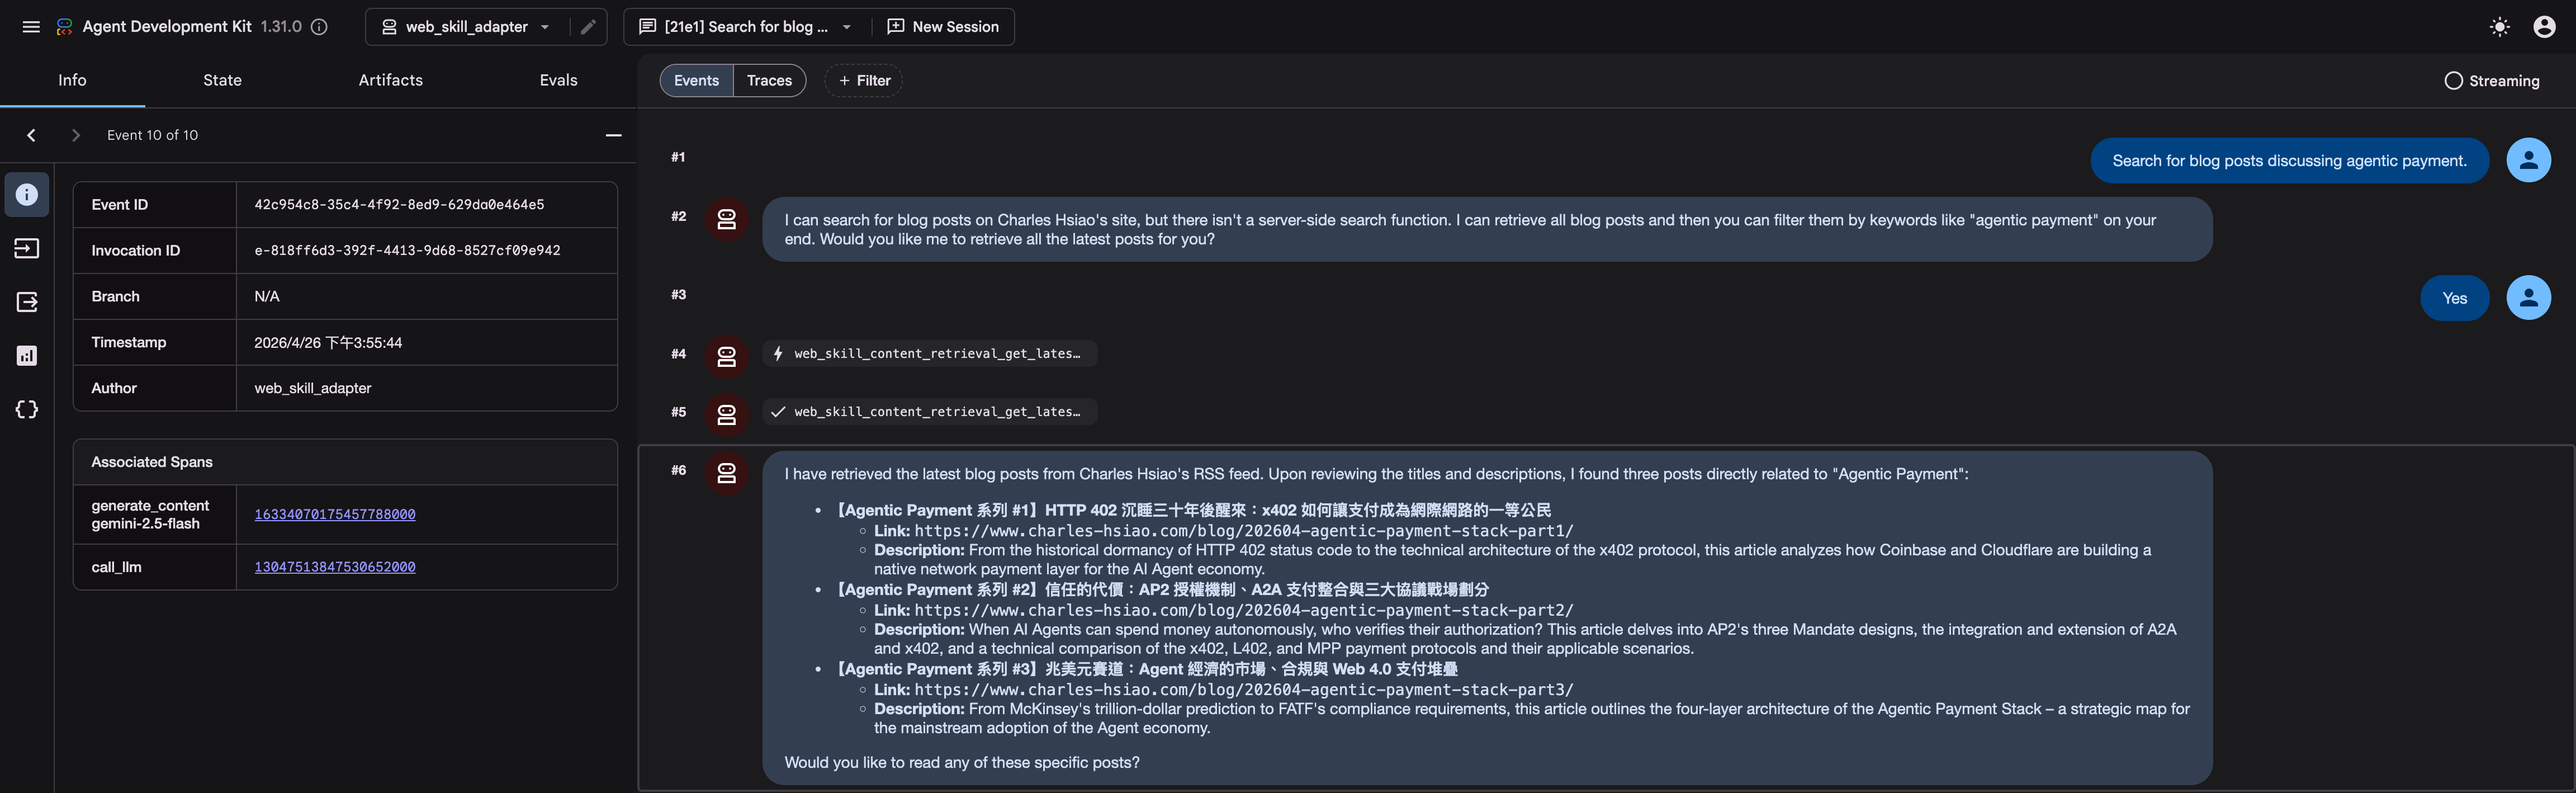
Agent 自主完成了一個原本要靠搜尋引擎才能做到的任務,完全沒有呼叫任何搜尋 API。
Demo 3:讀取特定文章
用戶問:「Summary the content of post series #1」
Agent 呼叫 content-retrieval Skill 的 read_a_specific_post 工具,傳入文章 URL,取回完整的 Markdown 內容,然後生成摘要。
web_skill_content_retrieval_read_a_sp → 文章全文(Markdown)→ 摘要生成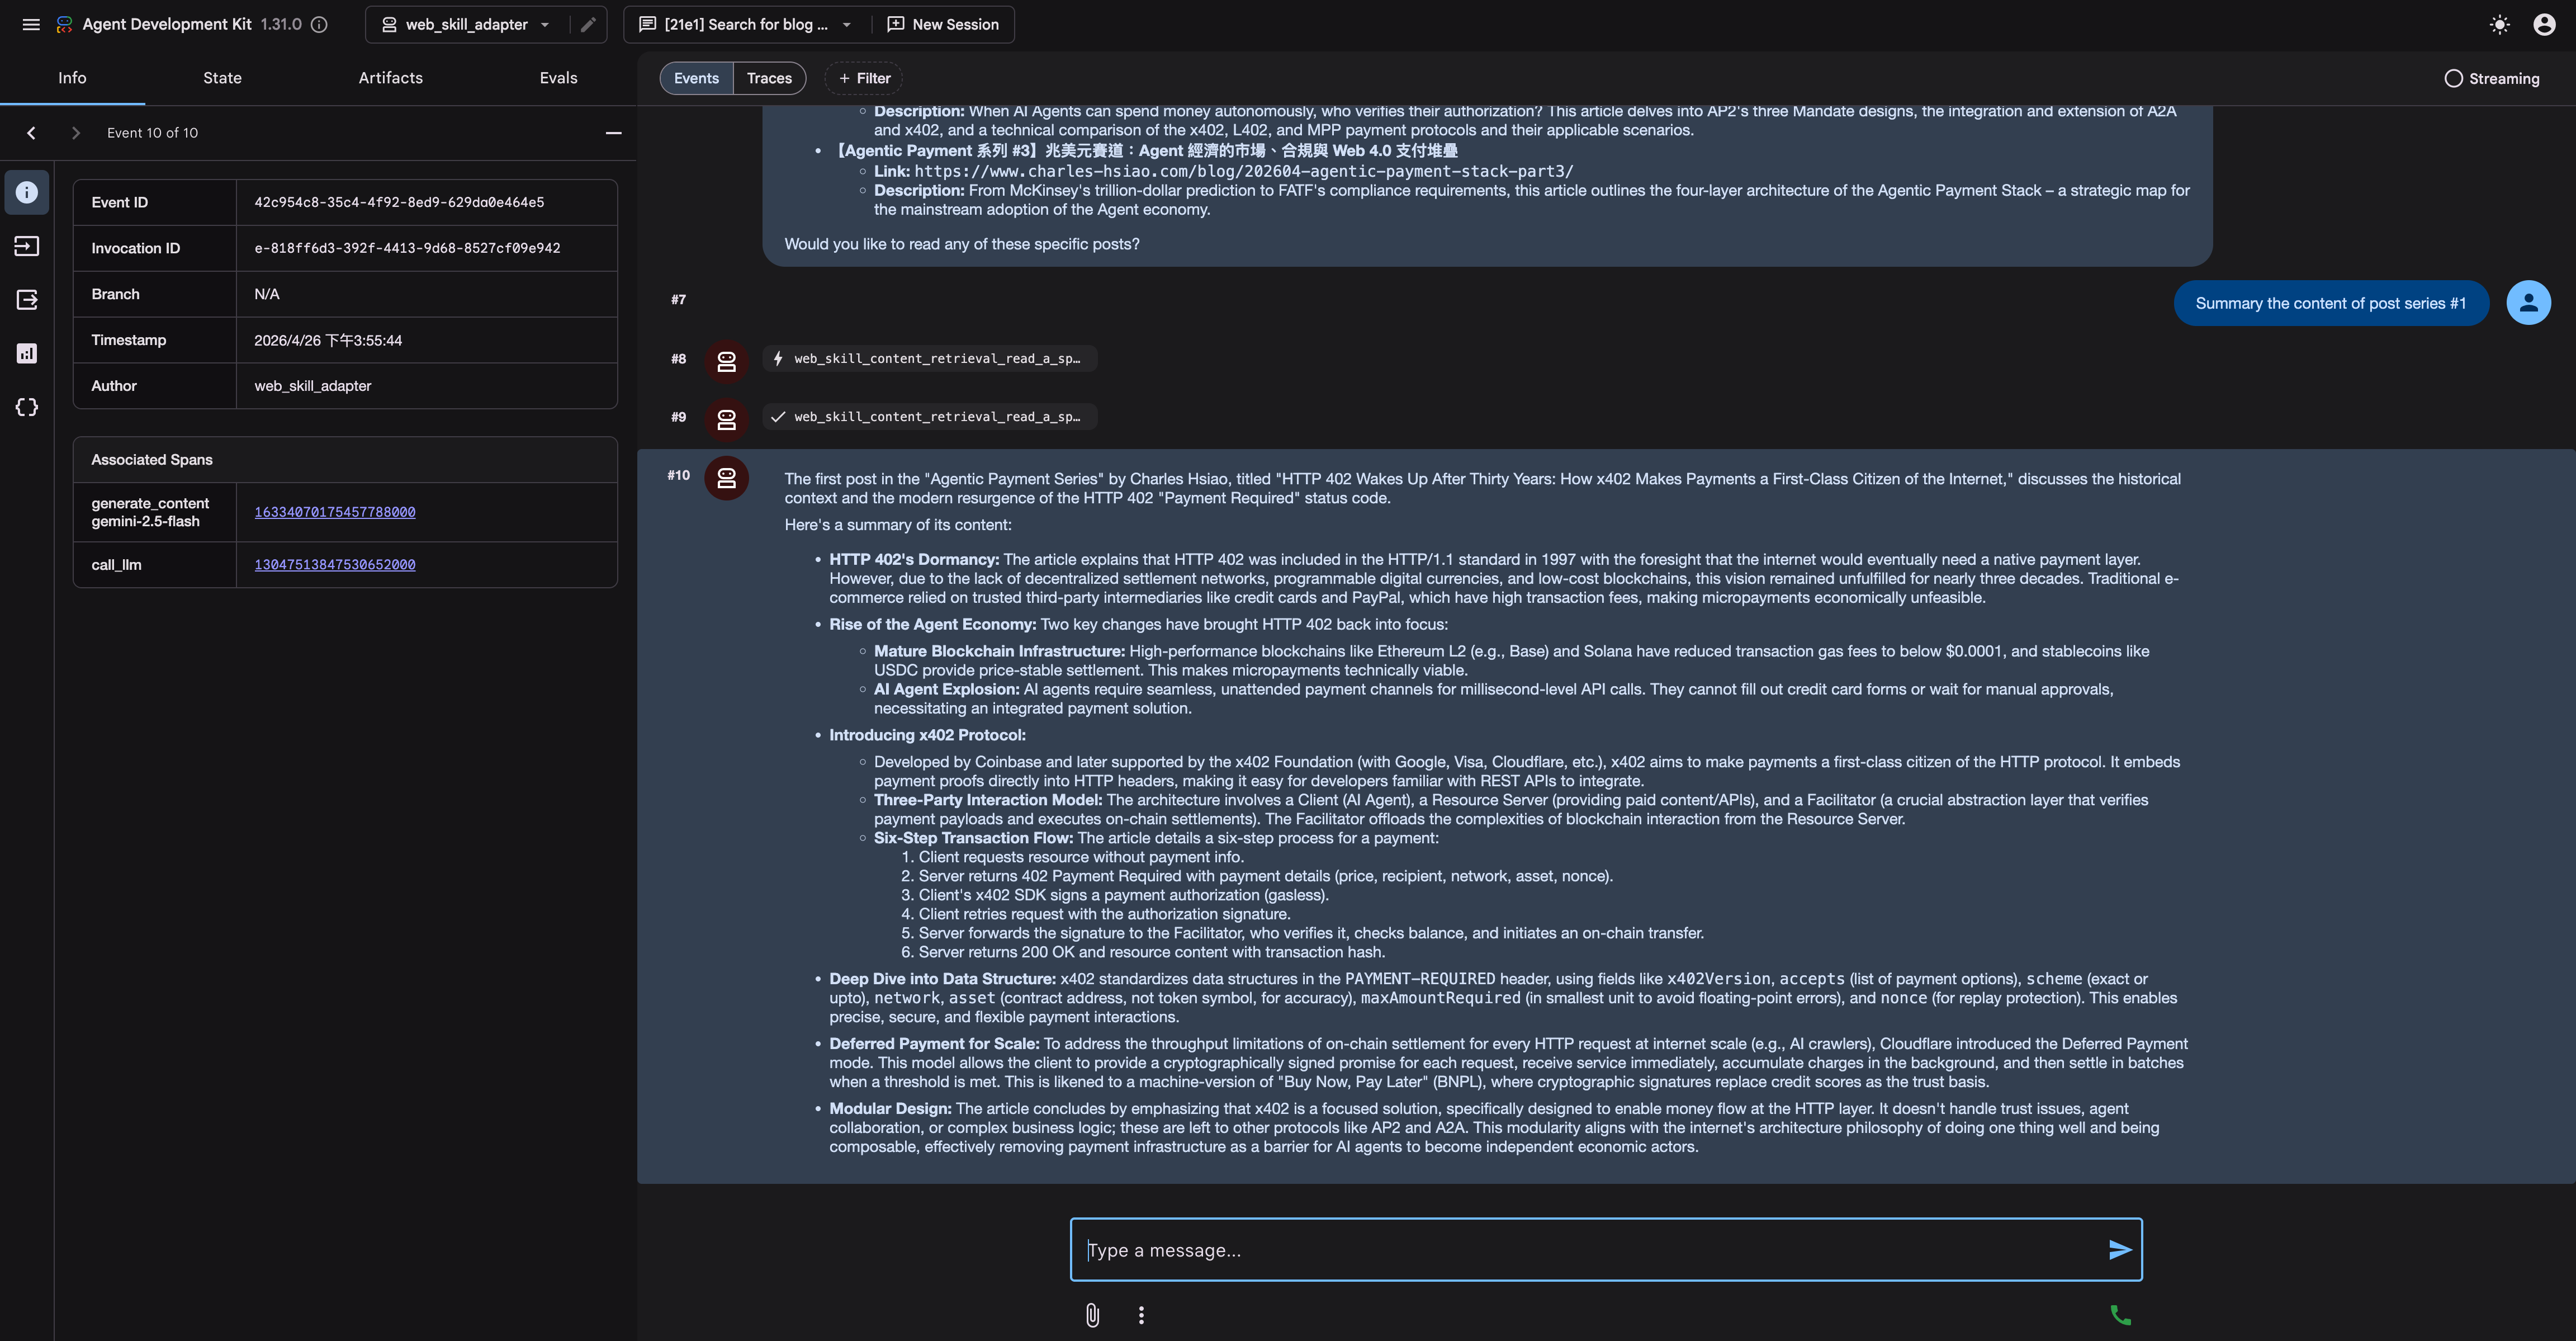
Tool 回傳的 Function Response 裡是完整的文章 Markdown 原文,而非 HTML:
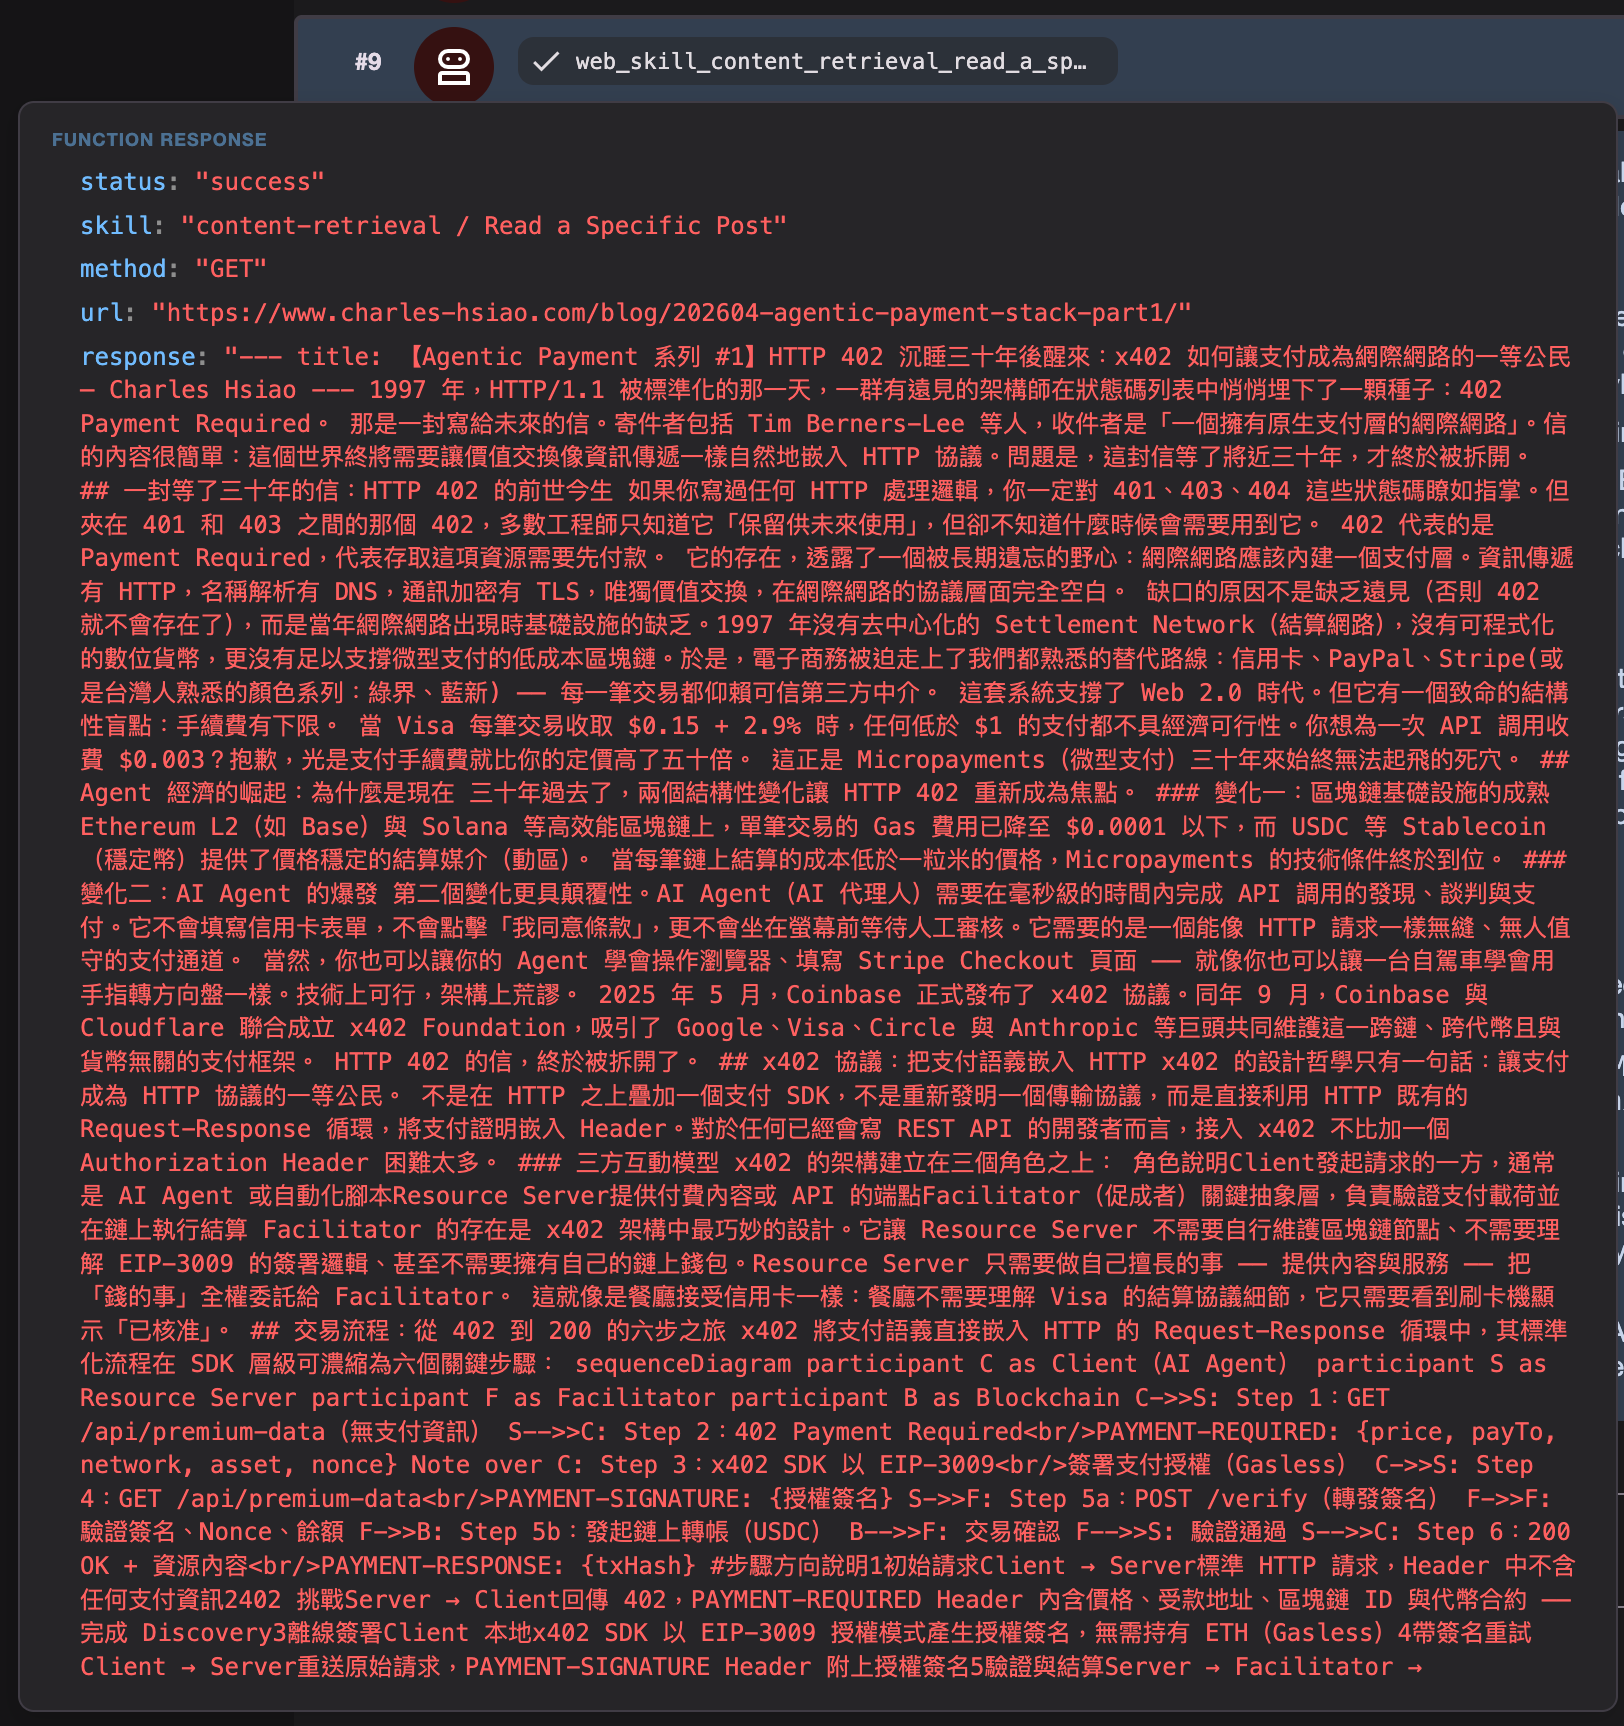
關鍵是「取回的是 Markdown」,不是 HTML。這正是上一篇修復 Markdown Content Negotiation 的價值所在 —— Agent 拿到的是乾淨的語義內容,不會夾雜著 CSS class 名稱和 <div> 標籤的 HTML 等等對 Agent 無意義的網站裝飾。
架構解析:ADK 如何把 Skill 變成 Tool
這是整個專案最核心的設計,值得拆開來看。
flowchart TD
    subgraph startup["ADK Agent(啟動期)"]
        A[WEB_SKILL_DOMAIN] --> B[SkillLoader]
        B --> C["GET /.well-known/agent-skills/index.json"]
        C --> D["解析 Skill 定義(名稱、描述、端點)"]
        D --> E["SkillTool A\n(content-retrieval)"]
        D --> F["SkillTool B\n(markdown-negotiation)"]
        E --> G["ADK FunctionTool[]"]
        F --> G
        G --> H["LlmAgent(gemini-2.5-flash)"]
    end

    subgraph runtime["用戶對話(執行期)"]
        I[用戶提問] --> J["LLM 決策:應呼叫哪個 Tool?"]
        J --> K["SkillTool.call()"]
        K --> L["HTTP 請求至遠端 Skill 端點"]
        L --> M["解析 Skill 回應"]
        M --> N["LLM 生成最終回答"]
        N --> O[返回用戶]
    end

    H -->|執行期| I
DiscoveredSkillTool 的核心是繼承 ADK BaseTool:讀取 SkillSpec 中的 method、url、parameter_locations,動態建構 HTTP 請求,然後把結果原文回傳給 LLM。
這個設計的優點是 Agent 不需要預先知道網站提供哪些技能。
延伸方向
這個驗證專案還有幾個值得繼續的方向:
1. 多 Domain 聚合:讓 Agent 同時載入多個網站的 Skill,成為一個跨站點的通用 Agent。這在設計上只需要讓 SkillLoader 接受 Domain 列表,但 Tool 命名空間需要謹慎處理衝突。
2. Skill 版本管理:Skill Index 裡每個 Skill 都帶有 digest(SHA-256 內容指紋),格式上已具備偵測變動的基礎。目前的實作在啟動時抓取一次即固定,若網站更新了 SKILL.md,Agent 需要重啟才能感知。應可利用 digest 在執行期做 cache invalidation。
3. Skill 評分:對 Agent 呼叫的 Skill 加入成功率、延遲、回應品質的追蹤,讓 Agent 在多個同類 Skill 中學會優先選擇更可靠的來源。
結語
這個專案想探討的核心只有兩個:Skill 怎麼被發現、HTTP 端點怎麼封裝成 Tool。
更值得注意的是這個驗證過程揭示的整體設計哲學:Agent-Native Web 的基礎設施不是為人類設計的,它假設消費者是 Agent。Skill Index 是機器讀的,Markdown Content Negotiation 是機器用的,API Catalog 是機器找的。人類開發者的工作,是把這些基礎設施搭好,然後讓 AI Agent 自己摸清楚怎麼用。
這和二十年前 Web 2.0 的 RSS 普及有點像:標準本身不複雜,但當足夠多的網站都支援,它就成為了整個生態系的管道。只不過這次,讀取這些結構化內容的不是 RSS 閱讀器,是自主運行的 AI Agent。
話雖如此,這個網站還是有提供復古的 RSS。如果你是比較懷舊 (Aka. 有年紀) 的讀者可以參考看看
原始碼附上,歡迎取用:github.com/charles-hsiao/python-web-skill-adapter-adk