【AIOps】被問到怕了,索性把 kagent 常見問題做成了 Cookbook
整理社群夥伴累積的常見 kagent 問題,建立 4 個可獨立執行的 Demo:BYO Agent 完整控制權、工具重用(MCP)、本地 LLM、Human-in-the-Loop。每個 Demo 自包含,一條指令即可在 kind 本地叢集跑起來。
演講結束後的 Q&A 時間,永遠是我最喜歡的部分。
觀眾會問出準備投影片時完全沒預料到的角度。三場 kagent 相關的議程下來——4 月的 Observability Day 2026、6 月的 DevOpsDays Taipei 2026、7 月的 Cloud Summit 2026——加上社群夥伴在各種管道傳來的問題,我發現有幾個問題的出現頻率很高,或是我也不知道答案。
不如把它們整理成可以直接動手跑的範例吧!
這就是 kagent-cookbook 的由來。
為什麼是 Cookbook 形式?
Cookbook 這個命名借自組態管理工具 Chef — 那個曾經和 Puppet、Ansible 並列、近年隨著容器化浪潮逐漸式微的 CM 老將。Chef 用 Cookbook 來封裝一組相關的自動化配方(Recipe),概念很直觀:每道菜都要能獨立端上桌。你不需要從第一道做到最後一道;你有什麼食材、想解決什麼問題,就翻到那個章節。
這個 Repo 的每個 Demo 資料夾都自包含(self-contained)——各自有 README、Kubernetes manifests 與部署腳本,一條指令就能在 kind 本地叢集跑起來:
~$ ./demo-01-byo-full-control/deploy-kind.sh目前整理了 4 個情境,這四個都是三場 Talk 之後觀眾最常追問的問題。如果後續還有值得補充的典型場景,會持續更新。
Demo 01:BYO Agent 如何取得完整的 ADK 控制權?
「如果我需要自訂 Planner,或是用 kagent 不支援的 ADK 參數,要怎麼辦?」
答案是 BYO(Bring Your Own)Agent 模式。kagent 原生支援兩種 Agent 模型:
| 比較維度 | Declarative Agent | BYO Agent |
|---|---|---|
| 執行環境 | kagent 管理 | 你自己的容器 |
| ADK 設定 | 僅限 kagent 支援的參數 | 100% 自由設定 |
| 工具連接 | 透過 spec.tools 宣告 | 直接在程式碼中接線 |
| 上手難度 | 容易(只要 YAML) | 中等(需要打包容器) |
| 適用場景 | 標準工具組合 | 需要自訂 ADK 行為時 |
Demo 01 展示的核心場景是:在 BYO Agent 中使用 BuiltInPlanner,同時搭配 ThinkingConfig 與自訂 Callback。整個打包流程使用 kagent-adk(pip install kagent-adk),它把一個 ADK Agent 包成 A2A Server,省掉自己寫 HTTP 樣板的麻煩:
- 撰寫 ADK Agent 程式碼,掛上你需要的 Planner 和 Callback
- 用
kagent-adk把它包成在 port 8080 上監聽 A2A 協議的 Server - 打包成 Docker 映像檔
- 用一份 kagent YAML manifest 部署
關鍵的 BuiltInPlanner + ThinkingConfig 設定見 agent.py L31–36。
這個模式讓你在享受 kagent 提供的 Kubernetes 原生生命週期管理的同時,保留對 ADK 行為的完整掌控。
補充說明:
BuiltInPlanner目前只能在 BYO Agent 中使用,kagent 的 Declarative Agent 尚未 expose 相關設定欄位——ADK 本身已在 e162bb8 支援 Planner,但 kagent 的AgentSpec目前尚未包含Planner與ThinkingConfig欄位。後續要看官方是否會把這部分 expose 出來。
Demo 02:如何讓多個 Agent 共用同一組工具?
另一個高頻問題的背景是:「我自己寫了一個工具——比如查公司內部 API、或封裝一段自訂邏輯——想讓多個 Agent 都能呼叫,要怎麼辦?難道每個 Agent 都要各自打包一份?」
不需要。Demo 02 展示的是 把自訂工具包成共享 MCP Server,讓多個 Agent 重用的架構。
核心概念是把工具部署成一個獨立的 MCPServer Custom Resource,讓多個 Agent 透過 cluster 內部 DNS 直接連到同一個工具端點。這樣的設計帶來幾個實際好處:
- 工具版本集中管理:更新工具只要改一個 MCPServer,所有使用它的 Agent 自動受惠
- 降低每個 Agent 的設定複雜度:Agent YAML 只需宣告「我要用這個 MCPServer」,不需要重複填寫連線細節
- 符合 K8s 的資源管理思維:工具變成叢集內的一等公民,可以被 RBAC 保護、可以被 Namespace 隔離
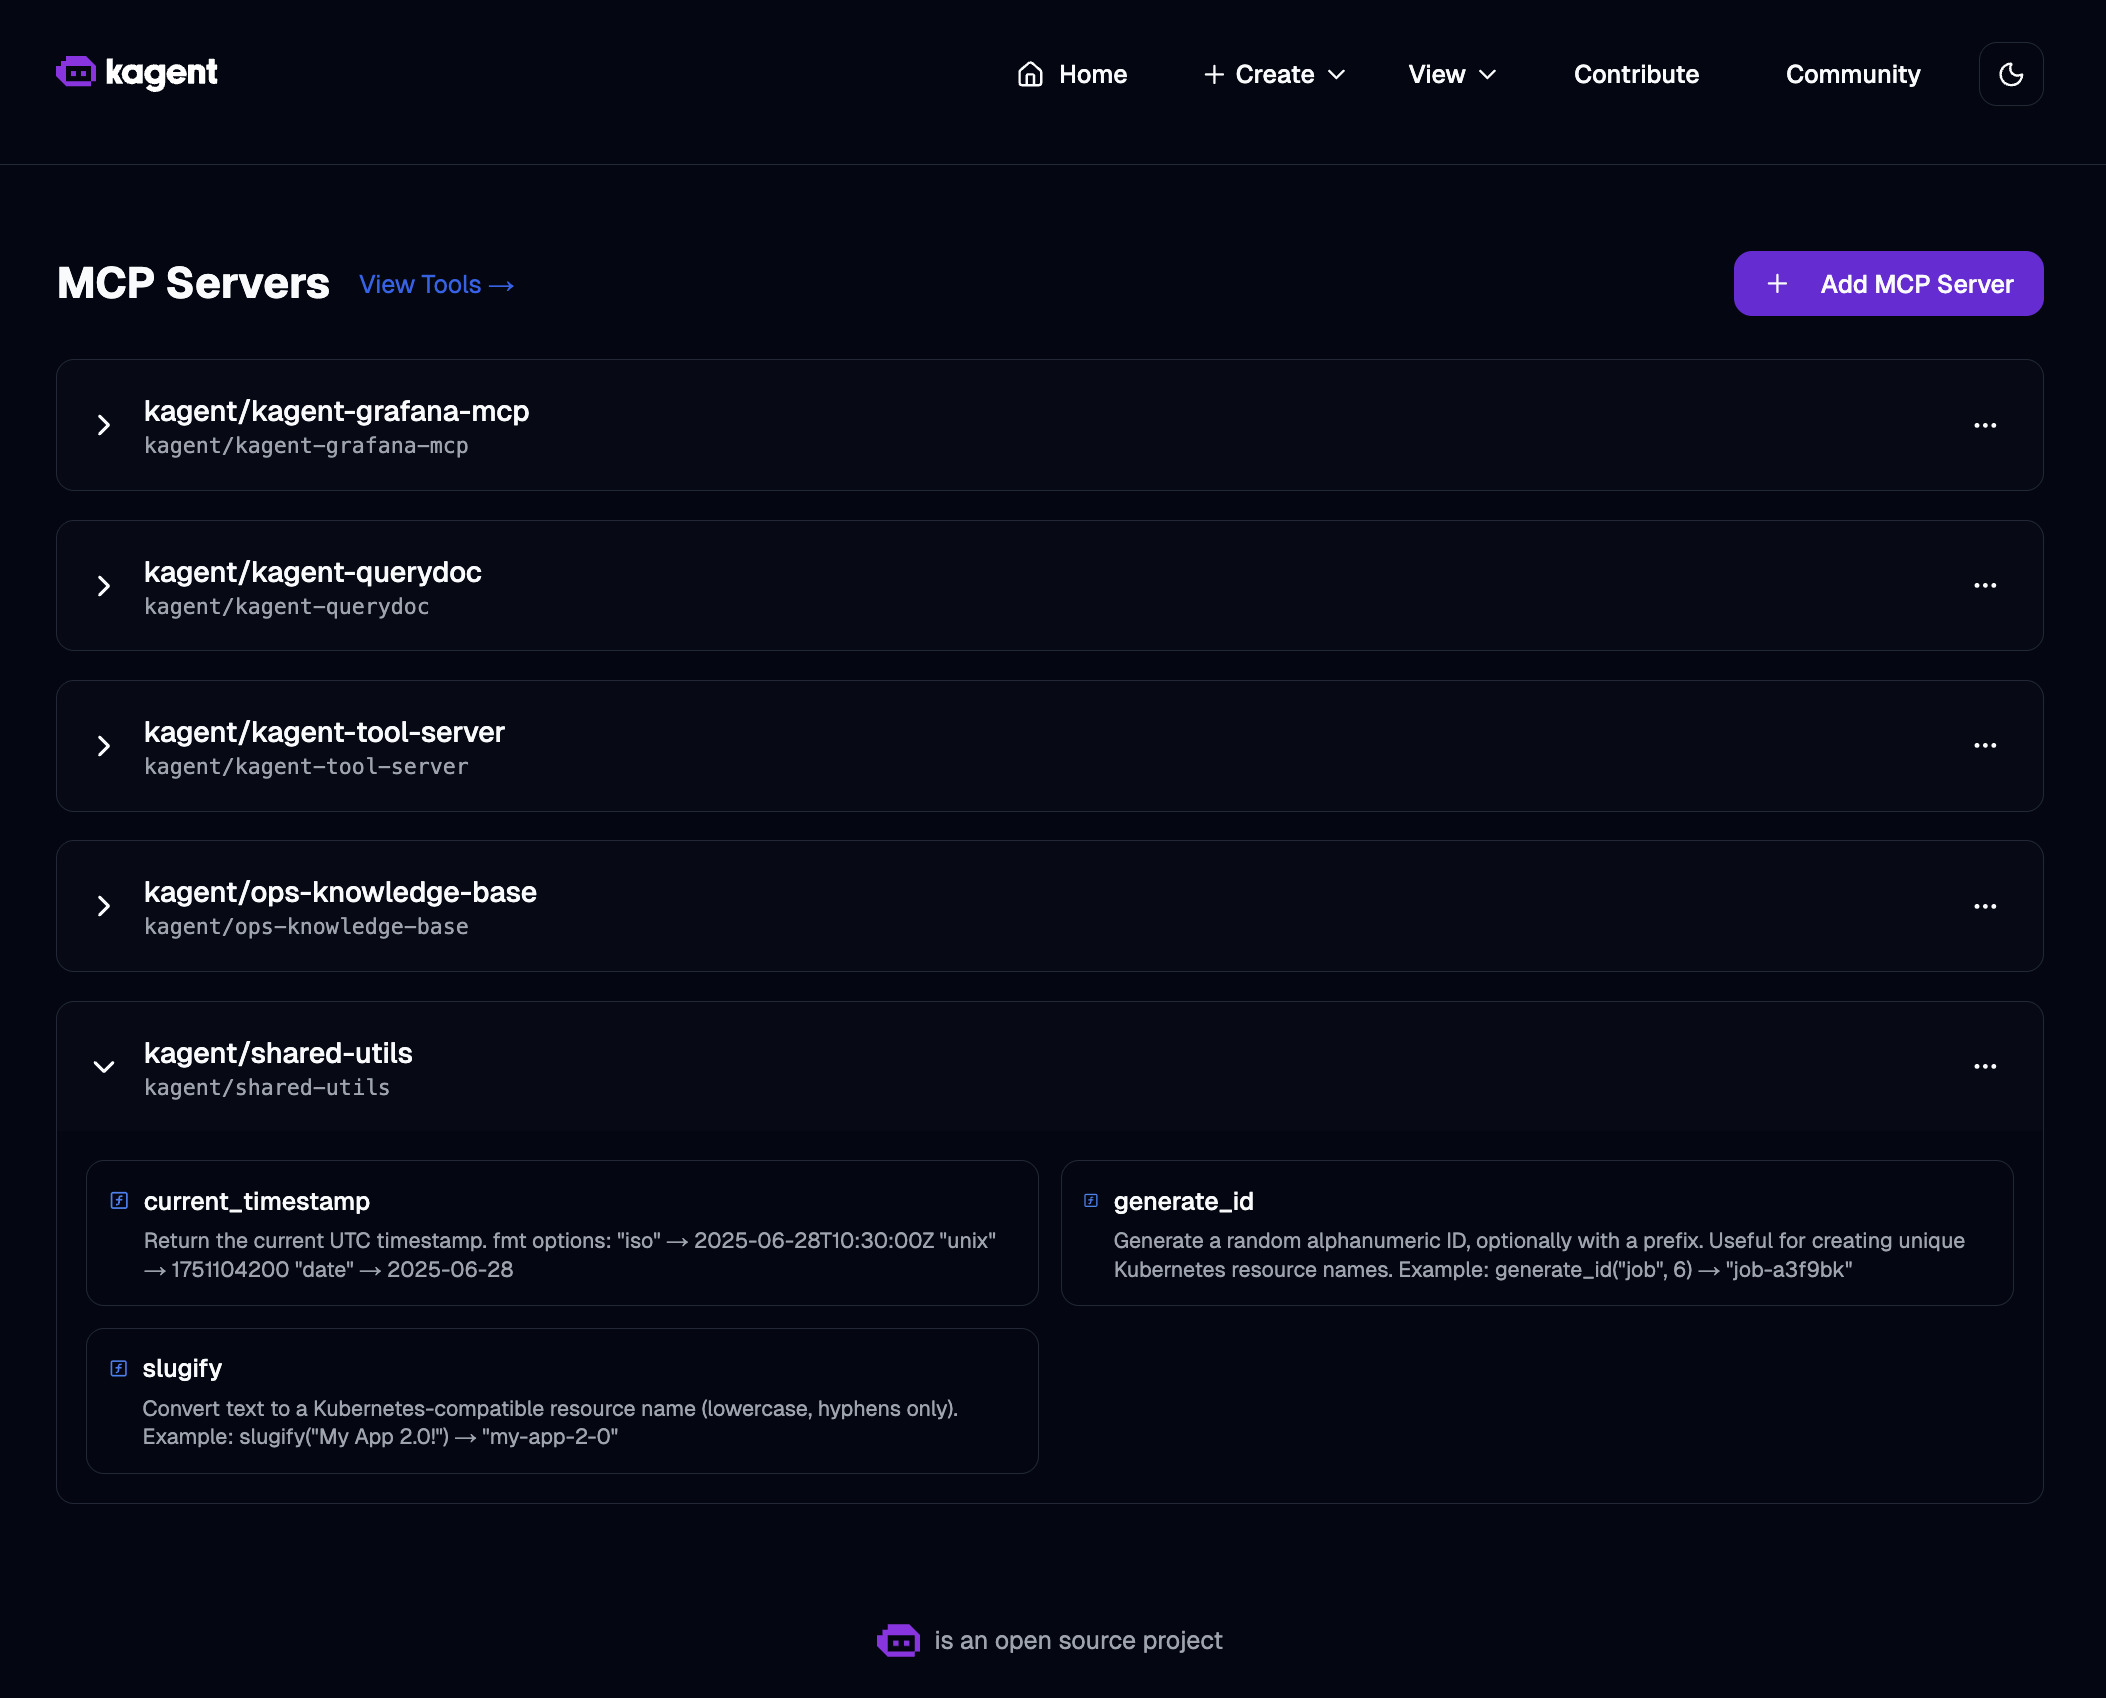
BYO Agent 也可以直接透過 cluster DNS 連到 MCPServer,不必經過 kagent 的代理層,適合需要低延遲工具呼叫的情境。BYO Agent 端的關鍵設定見 agent.py L18–25——MCP_SERVER_URL 透過環境變數注入,k8s/byo-agent.yaml 成為唯一的組態來源,切換環境(dev/staging/prod)只要改 YAML 即可。
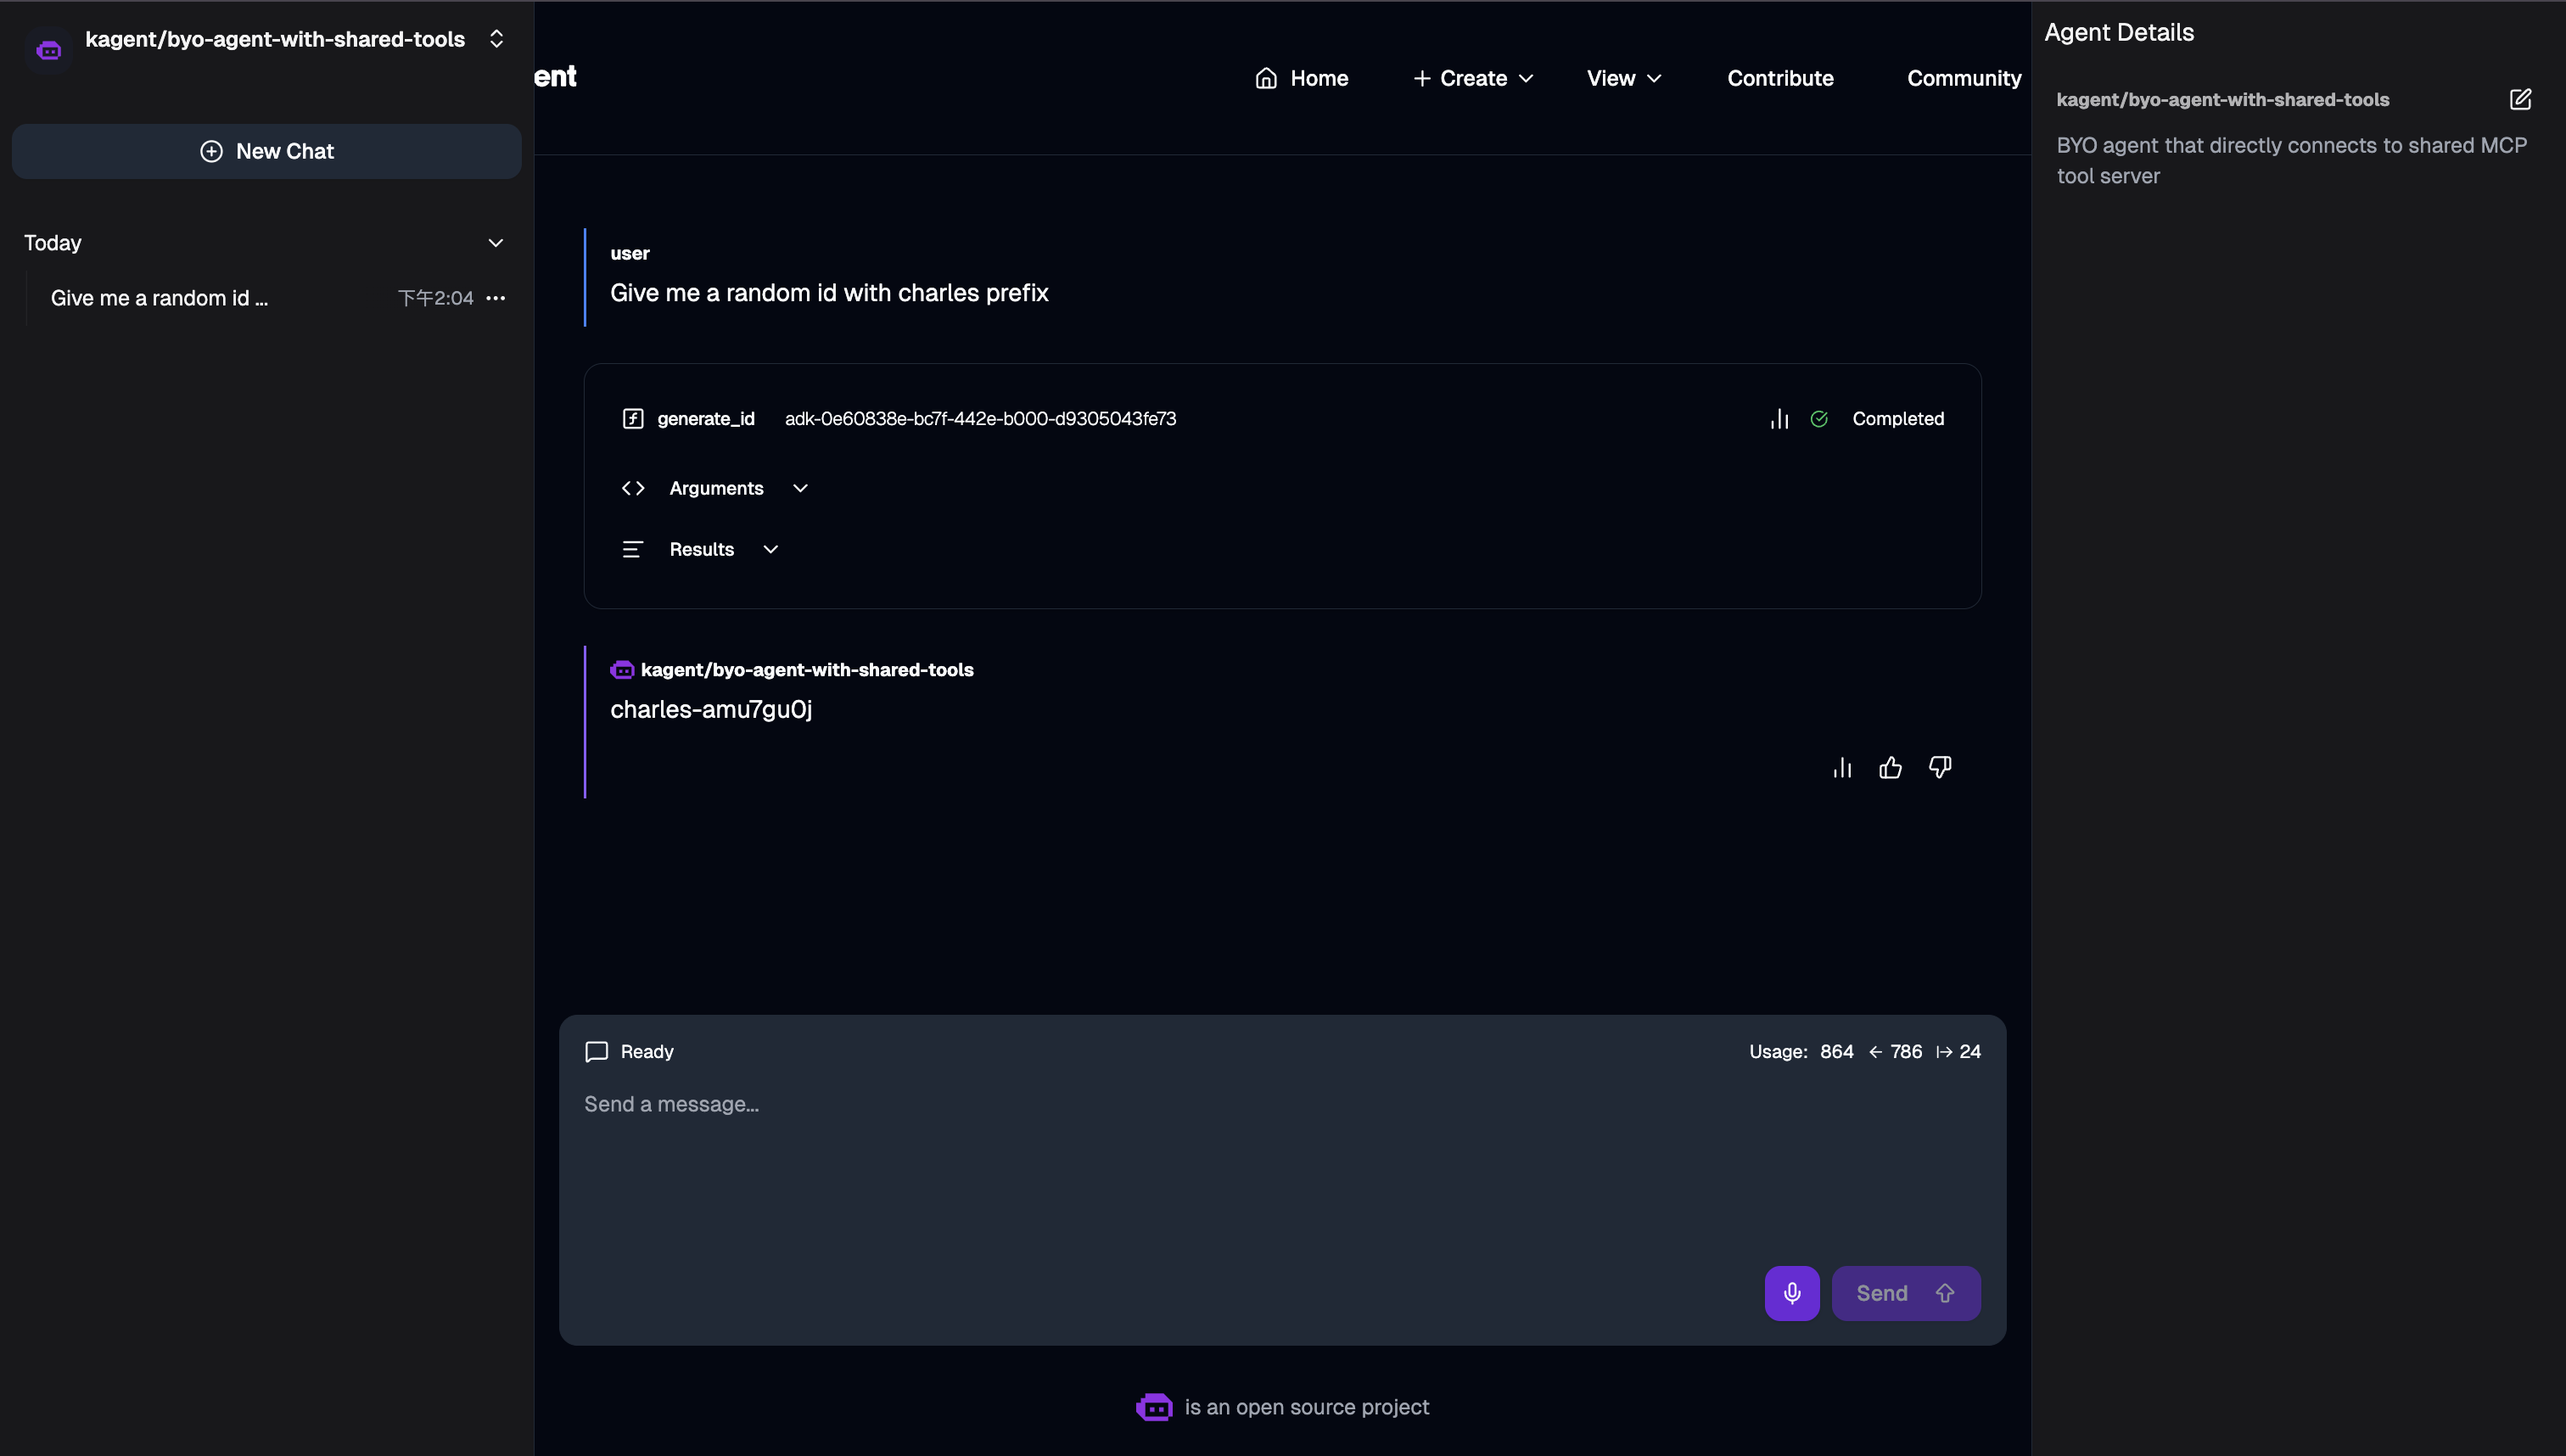
如果需要更細緻的 MCP 管控——例如跨 Agent 的流量管理、工具呼叫的 rate limiting 或 policy enforcement——可以進一步參考與 kagent 同屬 solo.io 的開源專案 agentgateway,它把 API Gateway 的管控概念延伸到 MCP 工具層。
Demo 03:如何在本地跑 Local LLM?
這個問題在每場 Talk 幾乎都有人問,通常伴隨兩個背後的顧慮:費用和資料安全性。
前者好理解——LLM API 的呼叫成本在 Agent 大量工具調用的情境下很容易失控。後者則是企業採用時的硬門檻:很多組織的 Kubernetes 叢集裡跑著不能離開 On-Premises 邊界的資料。
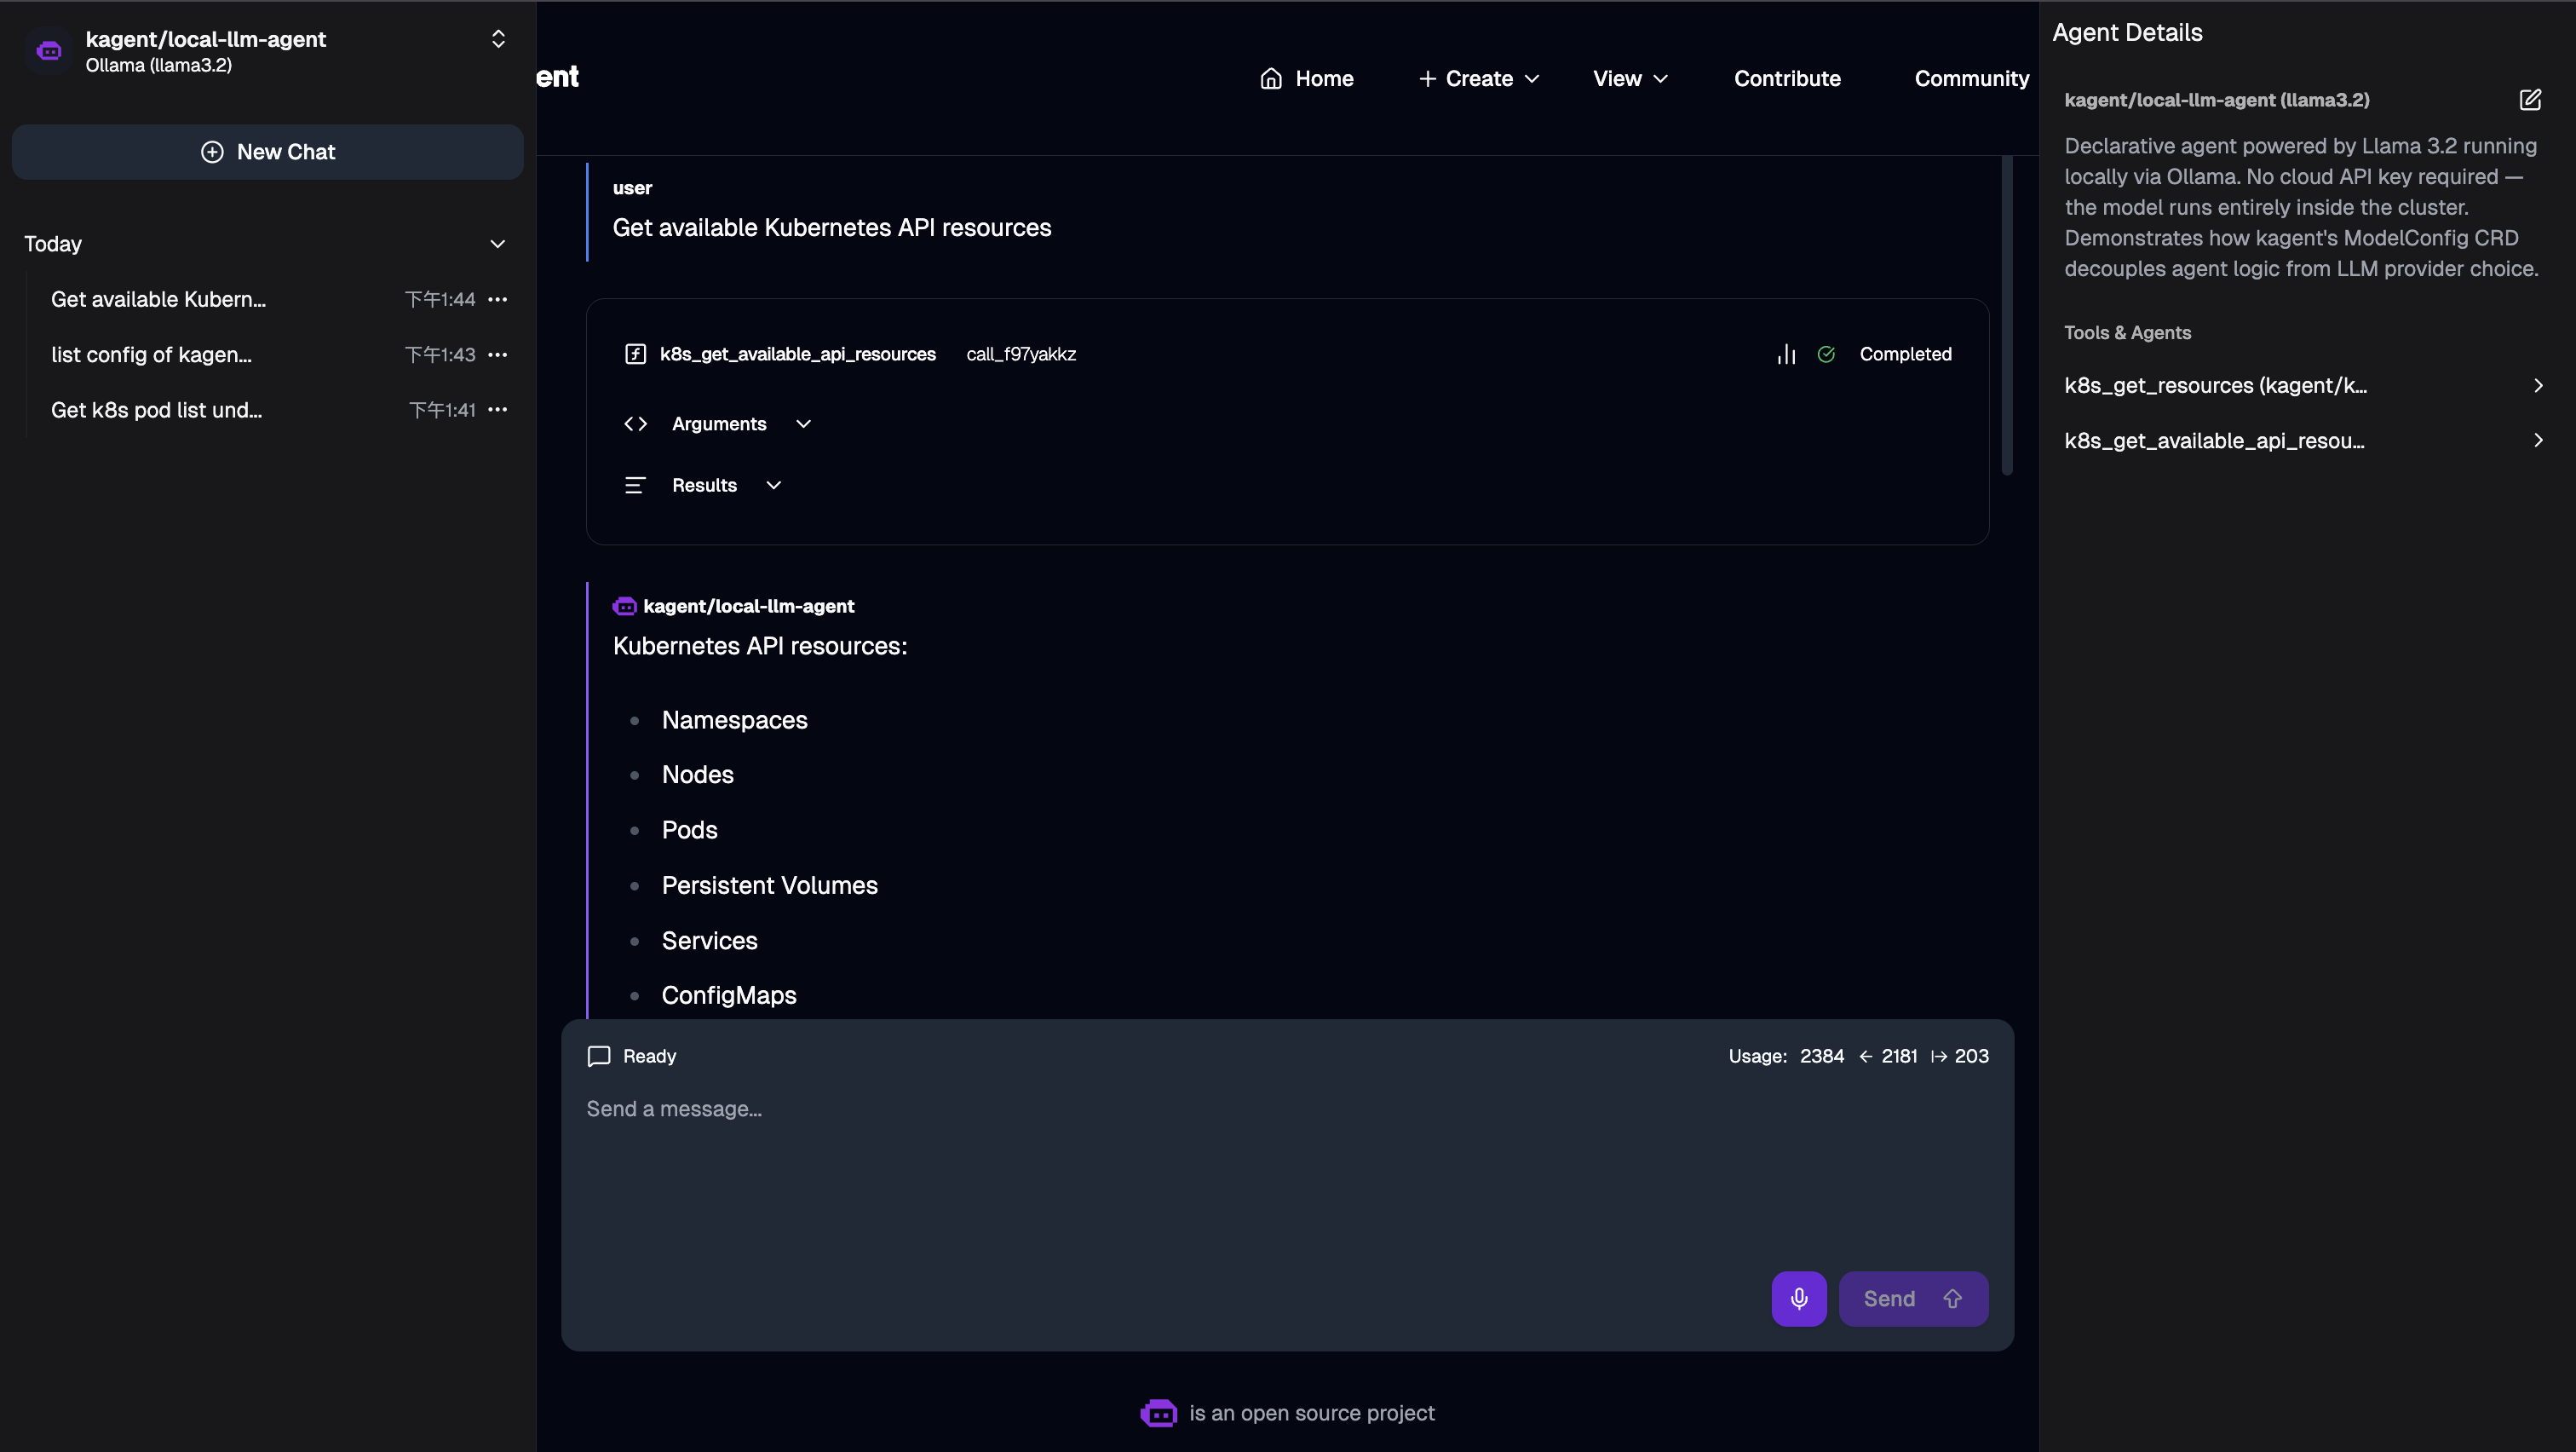
Demo 03 展示的是用 Ollama 搭配 kagent 的 Declarative Agent 模式,整個流程不需要任何雲端 API 金鑰:
~$ ./demo-03-local-llm/deploy-kind.sh三步組態完成整個串接:
- 用 ollama.yaml 把 Ollama 部署進 cluster
- 透過 modelconfig.yaml 建立指向 Ollama cluster 內部 endpoint 的
ModelConfigCR - Agent manifest 在 agent.yaml L19 引用該
ModelConfig名稱即可——其餘寫法與使用雲端 LLM 時完全一致
這正是 kagent 整合 A2A 的強大之處:每個 Agent 可以依據任務複雜度與資料敏感度,各自選擇最合適的 LLM。簡單任務或包含敏感資料的 Agent,跑地端模型(Ollama)或輕量外部模型:省 token 費用、避免敏感資料外流;需要執行或規劃複雜任務的 Agent,則選用外部能力較強的模型。不同 Agent 用不同模型,在同一個叢集裡同時跑,切換的成本只是改一個 ModelConfig 引用。
BTW:就算同樣是地端模型,能力也有強弱之分——qwen2.5:3b 和 llama3.1:70b 跑在同一台機器上,資源佔用和推理品質差距懸殊。同樣的邏輯可以套用在地端模型之間:依據任務複雜度與可用的本地算力,選擇適合的模型大小,而不是一律拉最大的。
Demo 04:Human-in-the-Loop — 讓 AI 在執行破壞性操作前先問你
這個問題的背後情緒我很能理解:「你怎麼確保 Agent 不會在凌晨三點自作主張刪掉什麼東西?」
信任 AI Agent 執行自動化操作,前提是你能控制它的邊界。Demo 04 展示的是 kagent 的 requireApproval 機制,也就是業界通稱的 Human-in-the-Loop(HITL)。
設計原則很直觀:
- 讀取操作(Read ops):Agent 可以自由執行,不需要等人確認
- 寫入操作(Write ops):Agent 在執行前暫停,等待人工 sign-off
這個機制透過在 Agent CR 的 spec 中宣告哪些工具需要 approval 來實現。關鍵設定見 hitl-agent.yaml L45–48——toolNames 列出 Agent 可呼叫的所有工具,requireApproval 則是其中需要人工 sign-off 的子集,兩個欄位一起宣告即完成整個 HITL 邊界設定。被標記的工具呼叫會在 kagent UI 的審核佇列中出現,人類可以在介面上看到 Agent 的推理脈絡、即將執行的操作細節,然後決定批准或拒絕。
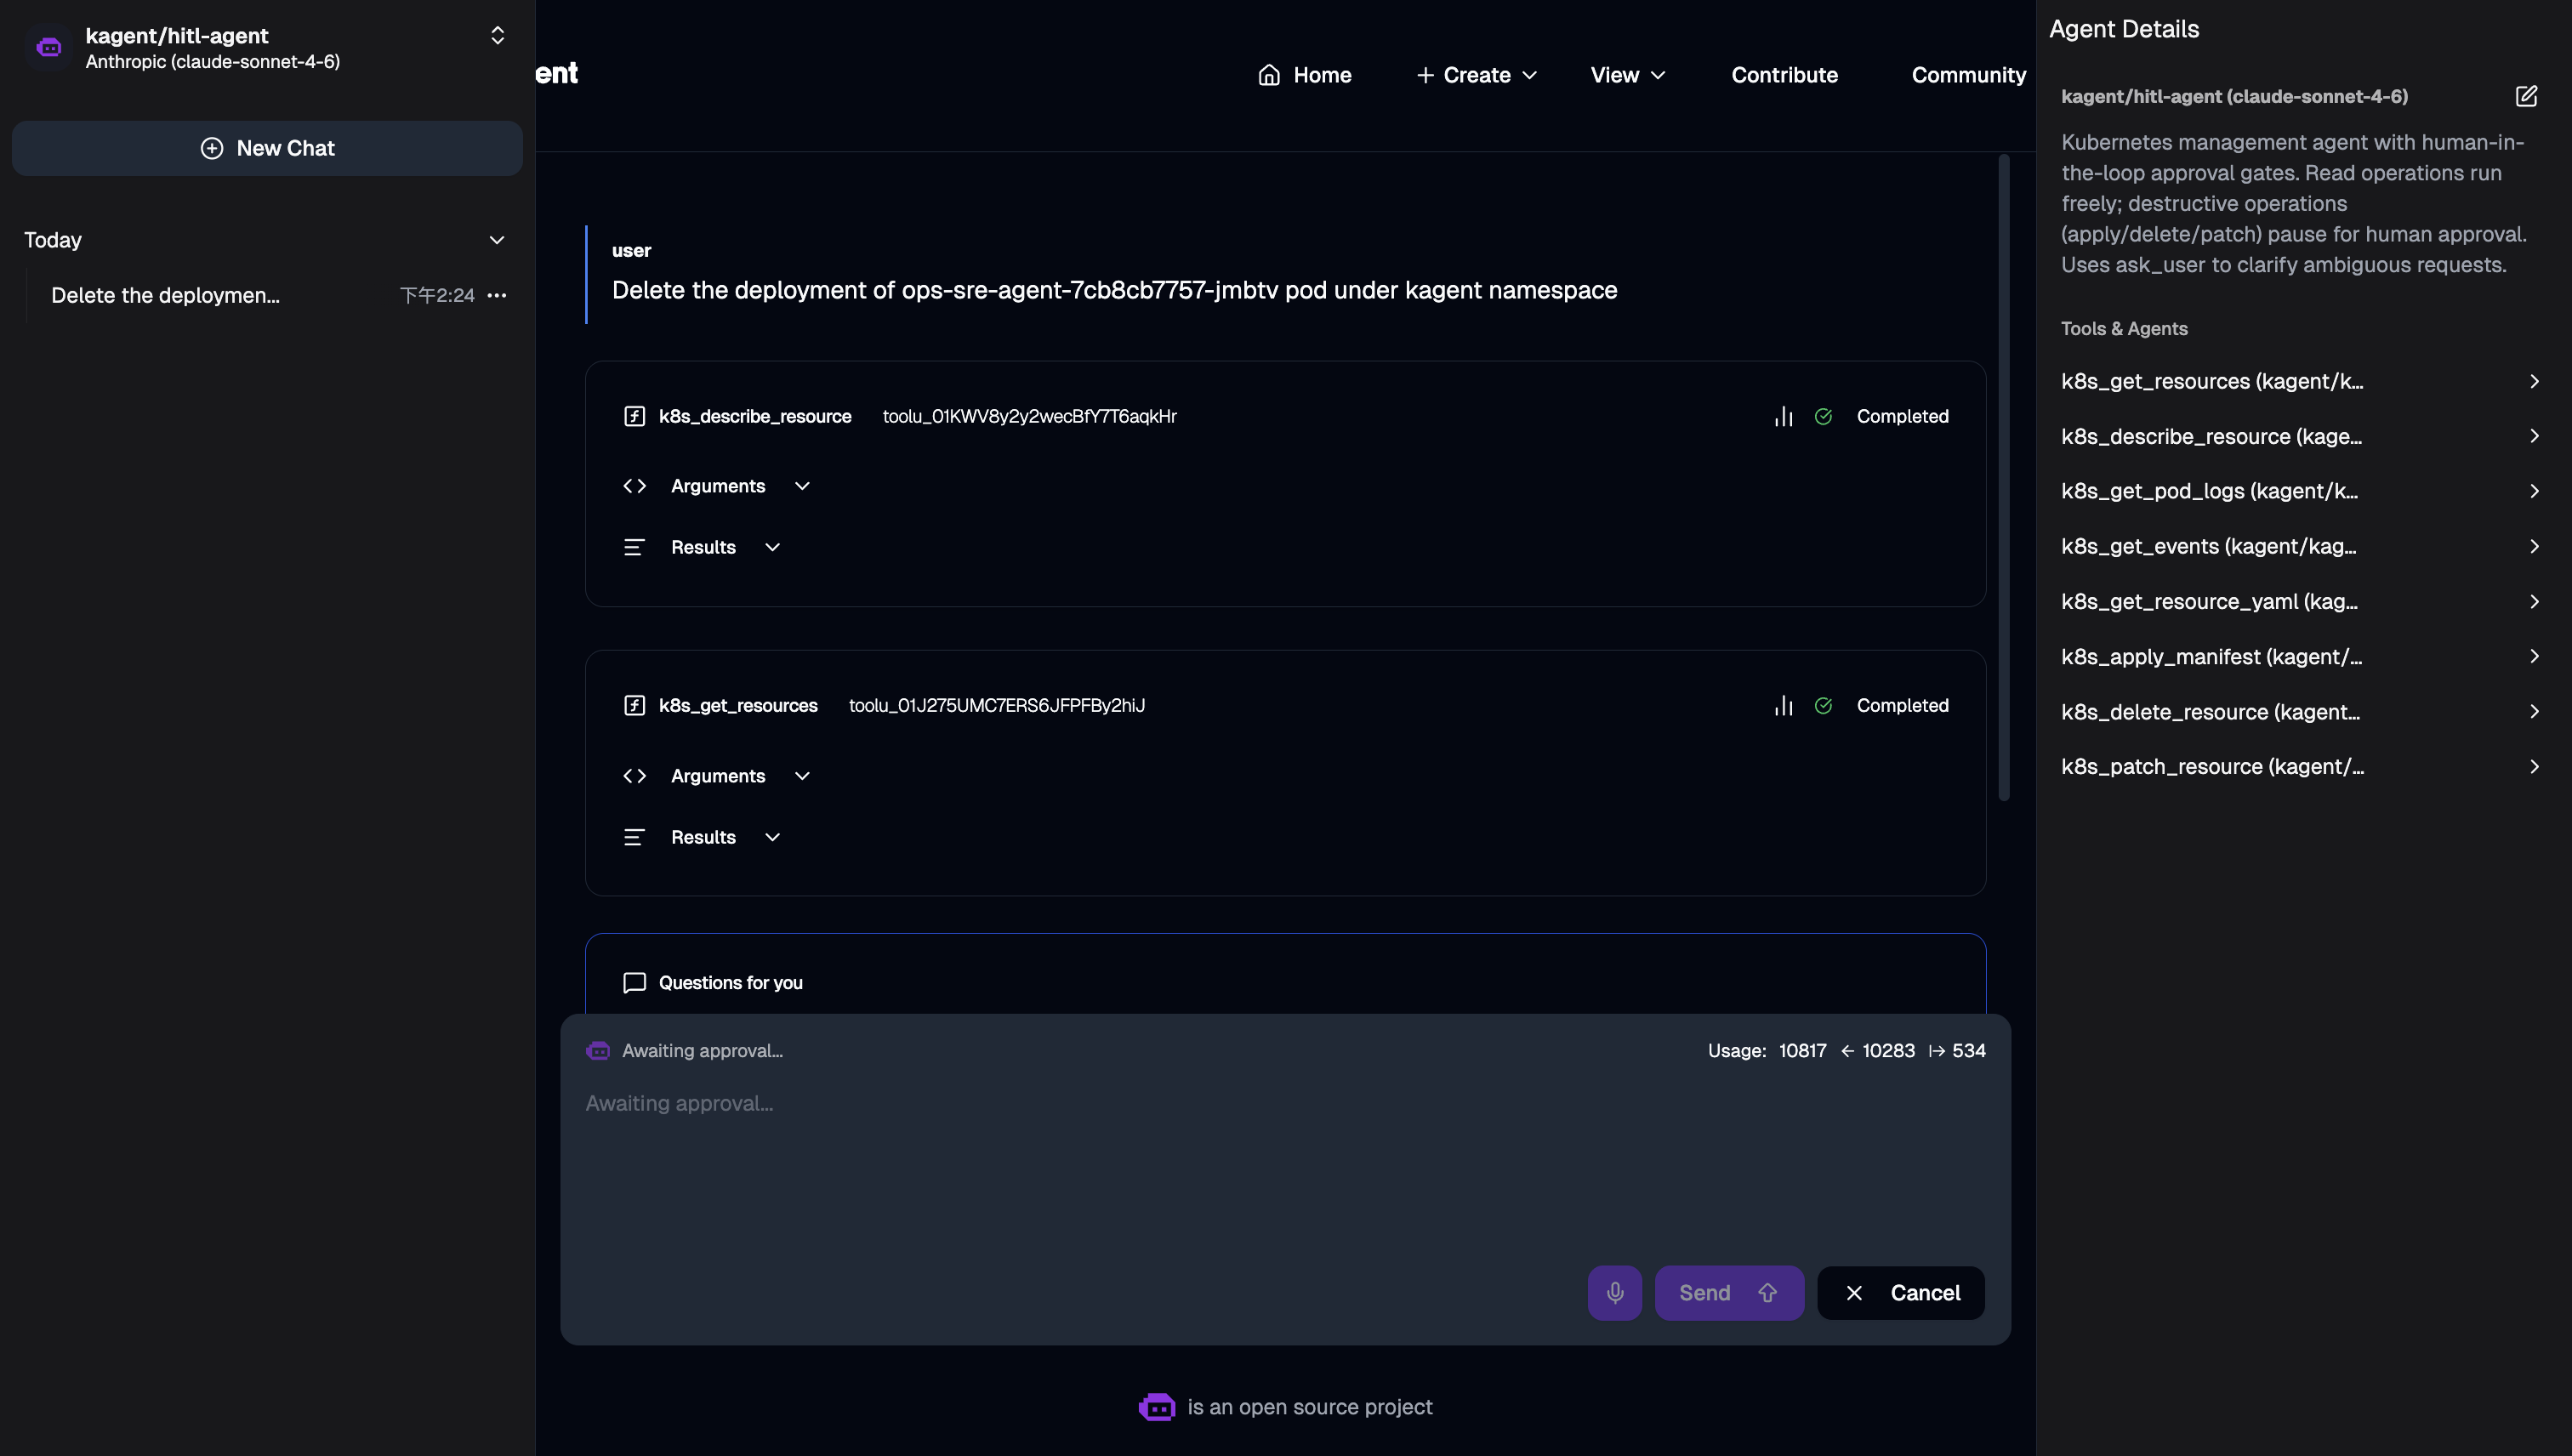
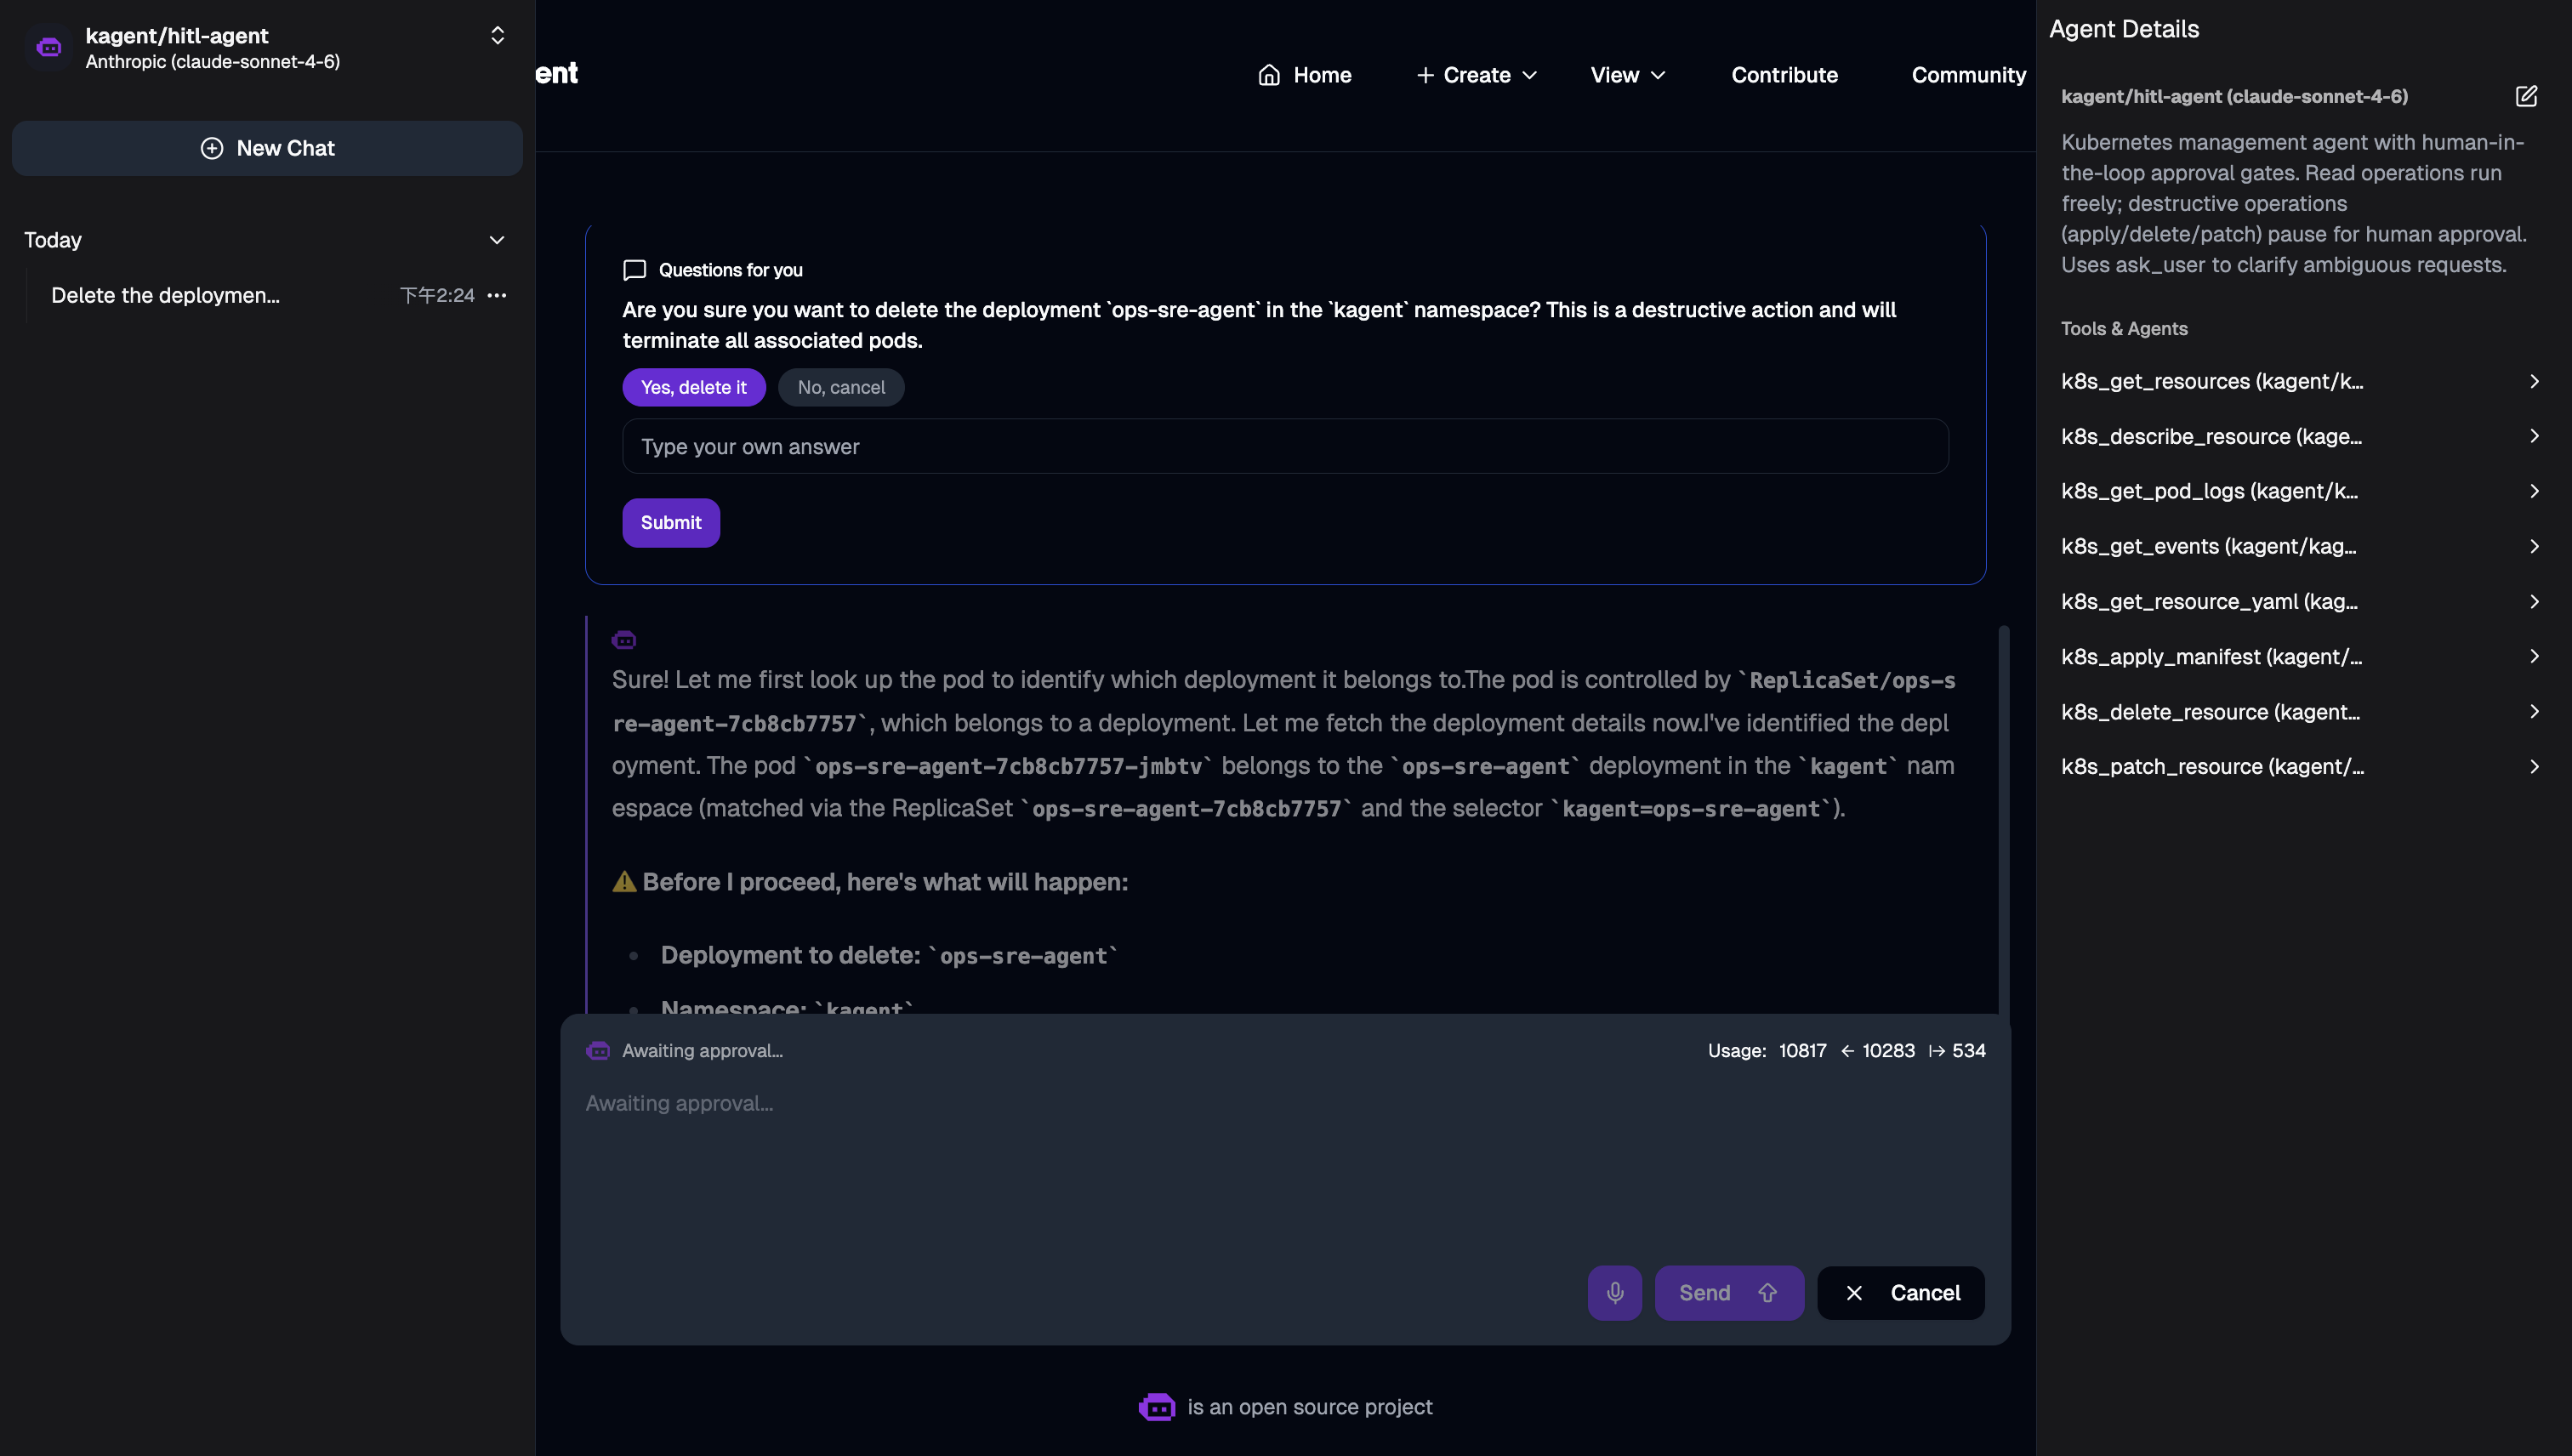
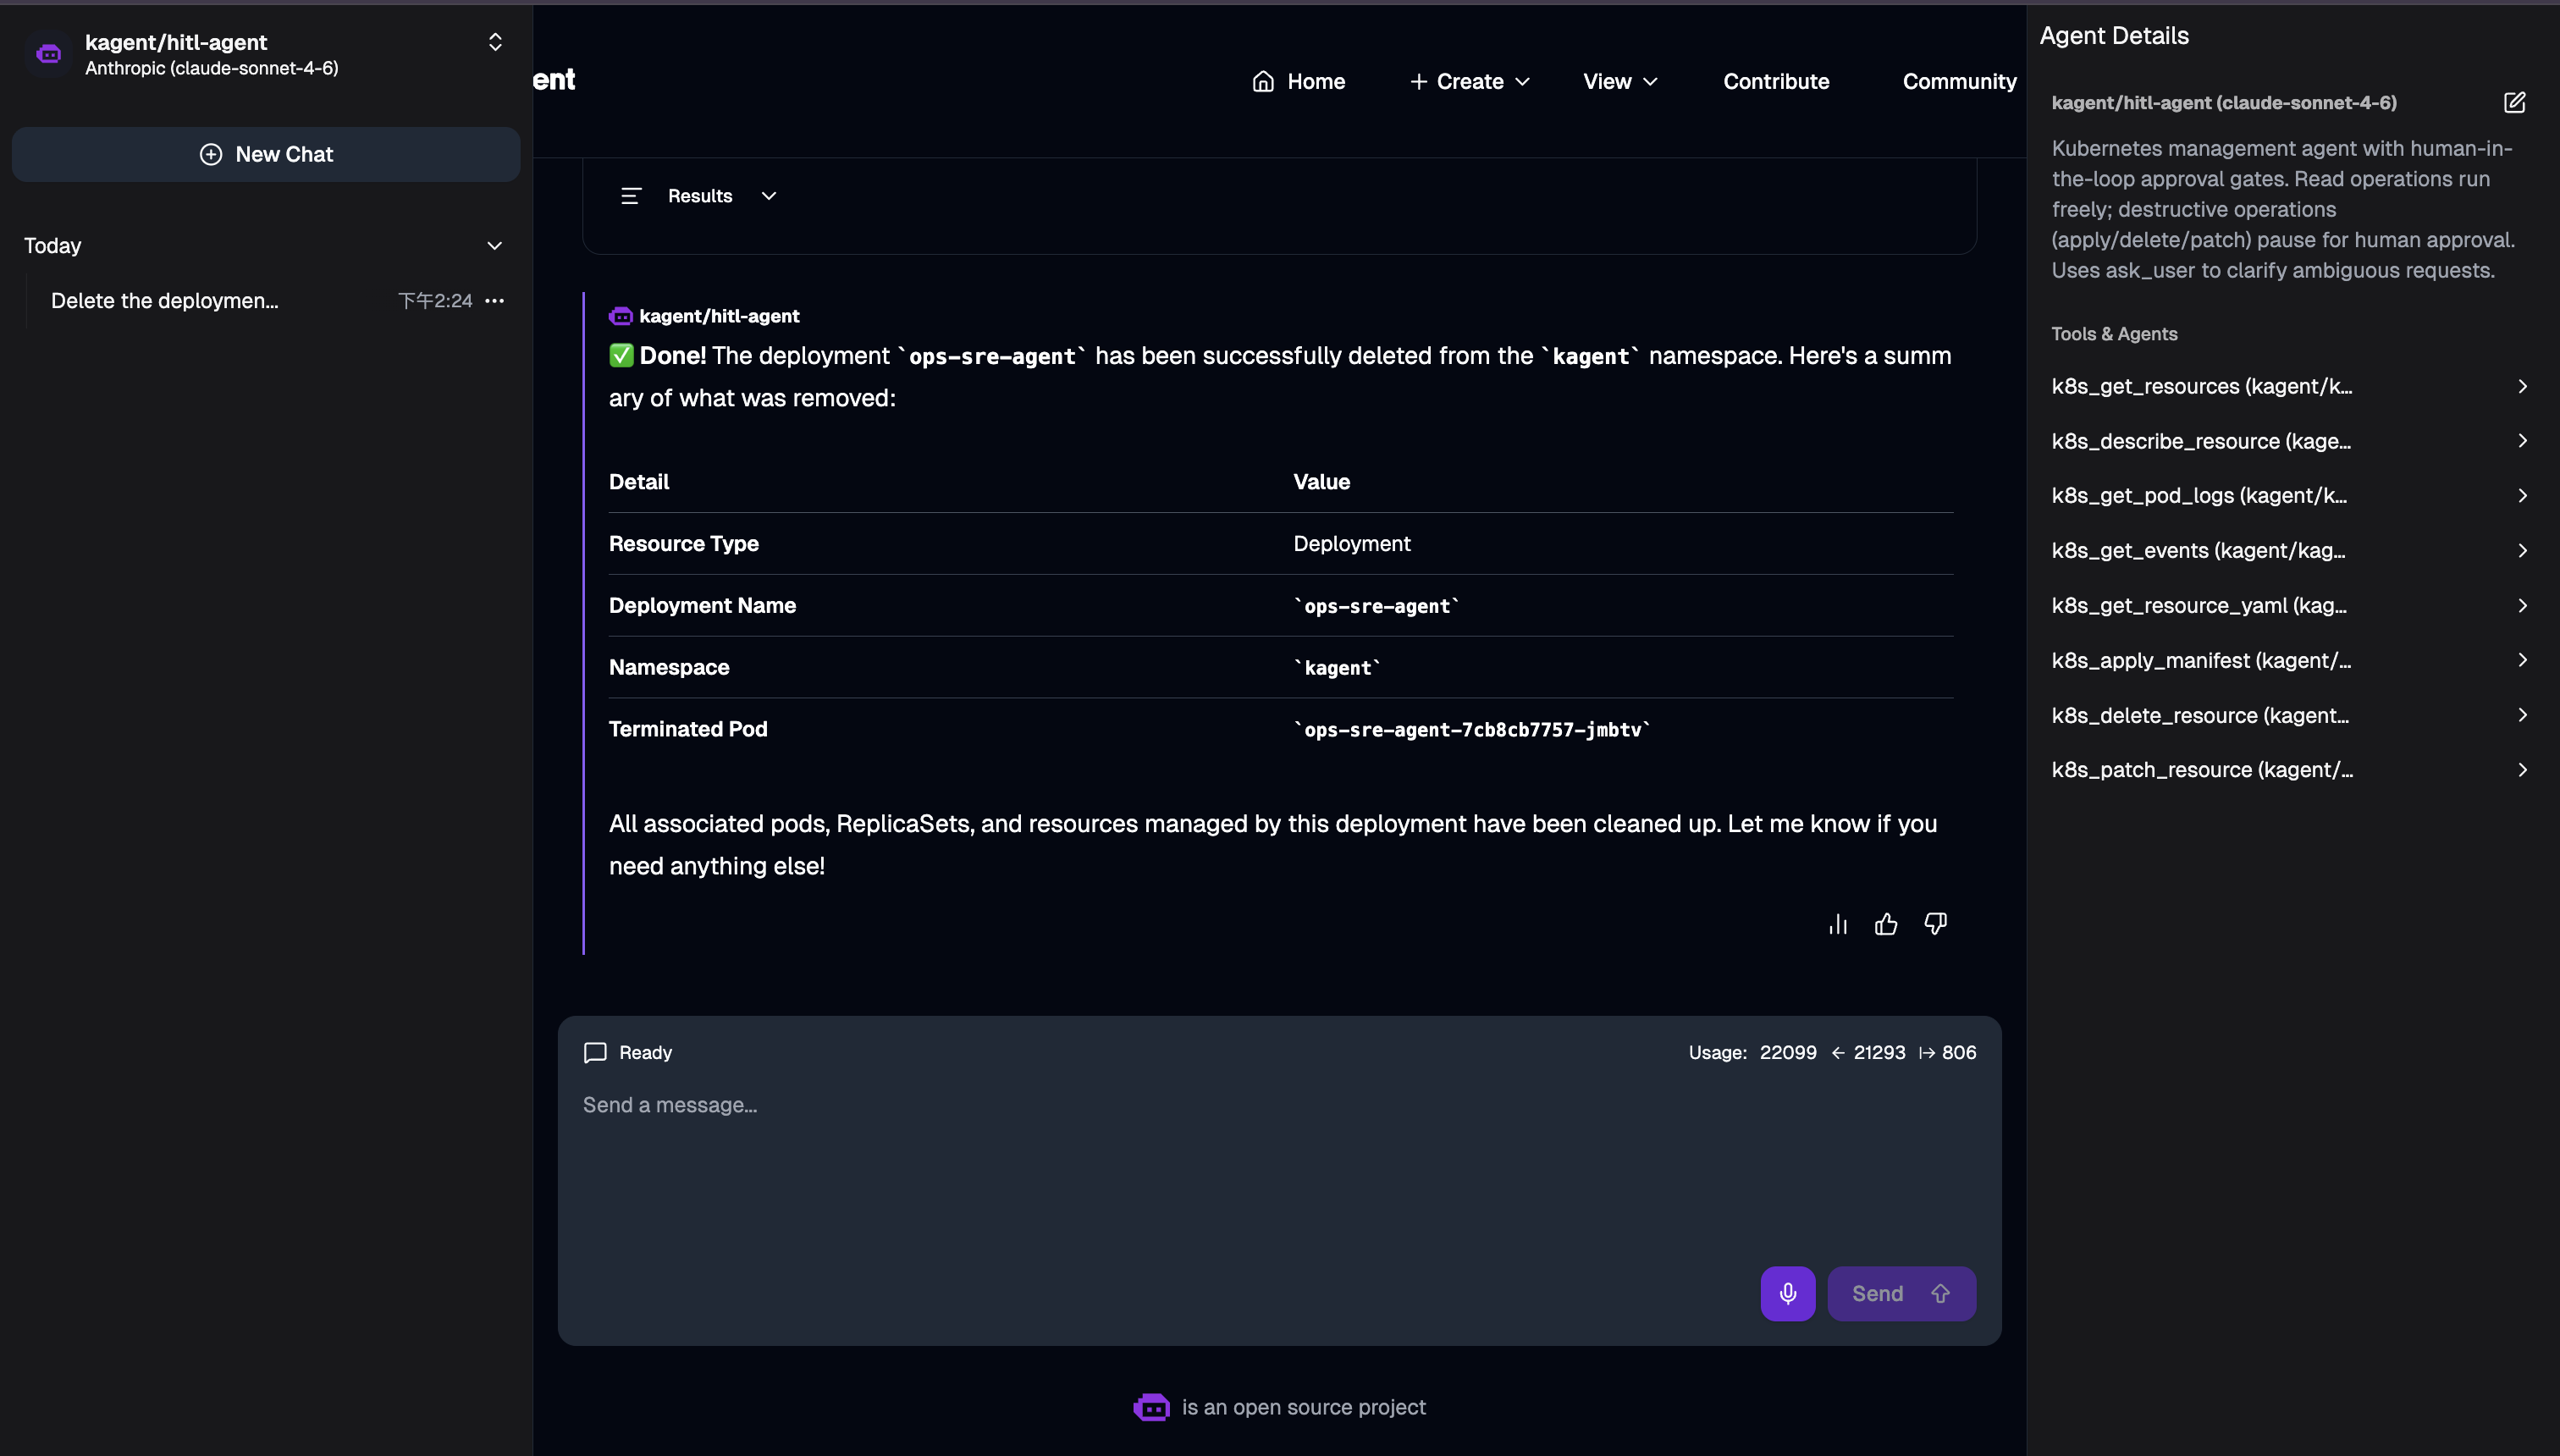
對於剛開始導入 Agentic SRE 的團隊,這是建立工程師對 AI 信任的實際路徑——不是一次性地把控制權全部交出去,而是以可見性換取逐步授權。
Agent 再強,不懂你的組織也是白搭
除了上面四個 Demo 的技術問題,還有一類問題同樣一直出現,只是性質不同:「聽起來很厲害,但 Agent 要怎麼知道我們公司自己的東西?怎麼把組織內部的 domain knowledge 變成 AI Agent 可以用的 context?」
這個問題的答案在另一篇文章裡:
延伸閱讀:【AIOps】Doc2Vec:用向量資料庫打造組織的儲思盆
簡短版本:kagent-dev/doc2vec 是一個開源工具,負責把散落在 Notion、Confluence、GitHub 等地方的技術文件拉進來、向量化、存進向量資料庫,讓 kagent Agent 可以用 MCP 協議查詢這些知識。上面那篇文章有完整的架構說明和實作細節。
如果你想要一個可以直接動手跑的端到端示範,我也整理了 kagent-doc2vec-demo——把 Runbook 和 Postmortem 向量化、打包成 MCP Server 映像檔、部署進 Kubernetes,並掛載到 kagent Agent 的完整流程,四步指令跑完。
這個 Repo 的邊界
最後說明一下這個 Cookbook 的定位。
它不是 kagent 的官方文件,也不是從零學習 kagent 的教學系列,這部分 kagent 官方文件 做得比我好。 kagent-cookbook 的定位是針對真實場景中實際被問到的問題給出可跑的答案,每個 Demo 都是一個「這個問題的最小可運行示範」。
如果你在使用 kagent 的過程中遇到無法在文件中找到答案的問題,歡迎開 Issue 或 PR——如果那個問題也足夠典型,它可能會變成第五個 Demo。